20.08.2026
За последние два года вокруг корпоративных данных появилось очень много новых терминов: онтология, таксономия, Knowledge Graph, semantic layer, context layer, context graph, GraphRAG. Часть этих понятий существовала задолго до нынешней волны генеративного ИИ, но именно появление аналитических агентов резко повысило к ним интерес. Причина довольно простая: оказалось, что одной большой языковой модели и прямого доступа к базе данных недостаточно, чтобы надежно отвечать на бизнес-вопросы. LLM умеет писать SQL, умеет объяснять результаты, умеет строить гипотезы, но сама по себе она не знает, что именно конкретная компания называет выручкой, какой показатель считается официальной EBITDA, какая дата используется для признания продажи, где заканчивается валовая прибыль и начинается операционная, можно ли анализировать складские остатки в разрезе клиентов и почему два похожих поля в DWH дают разные цифры.
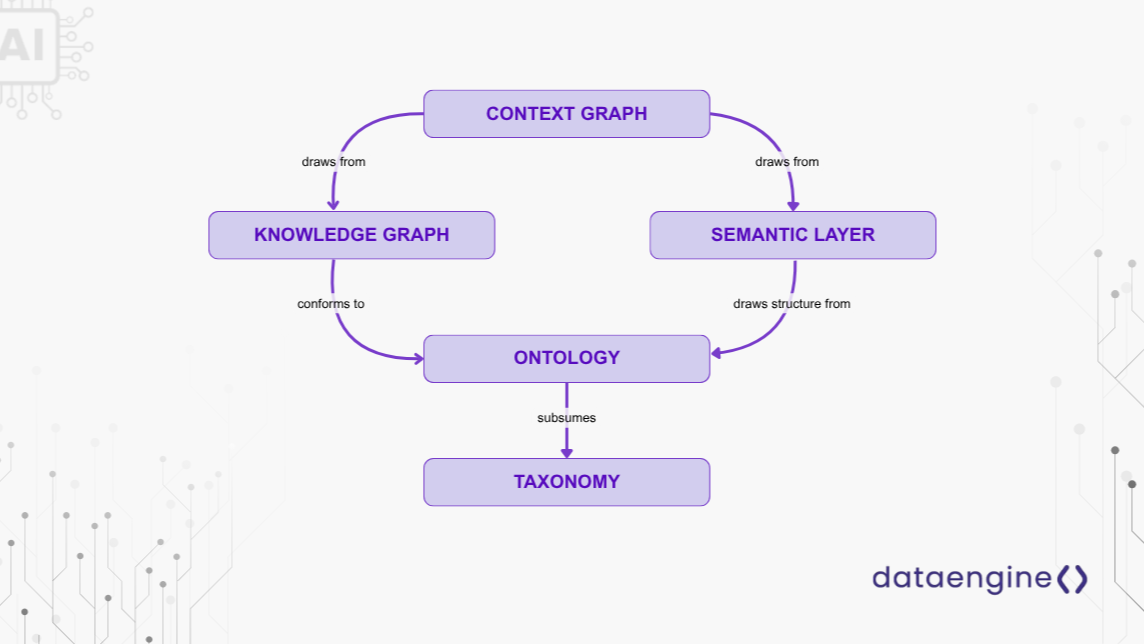
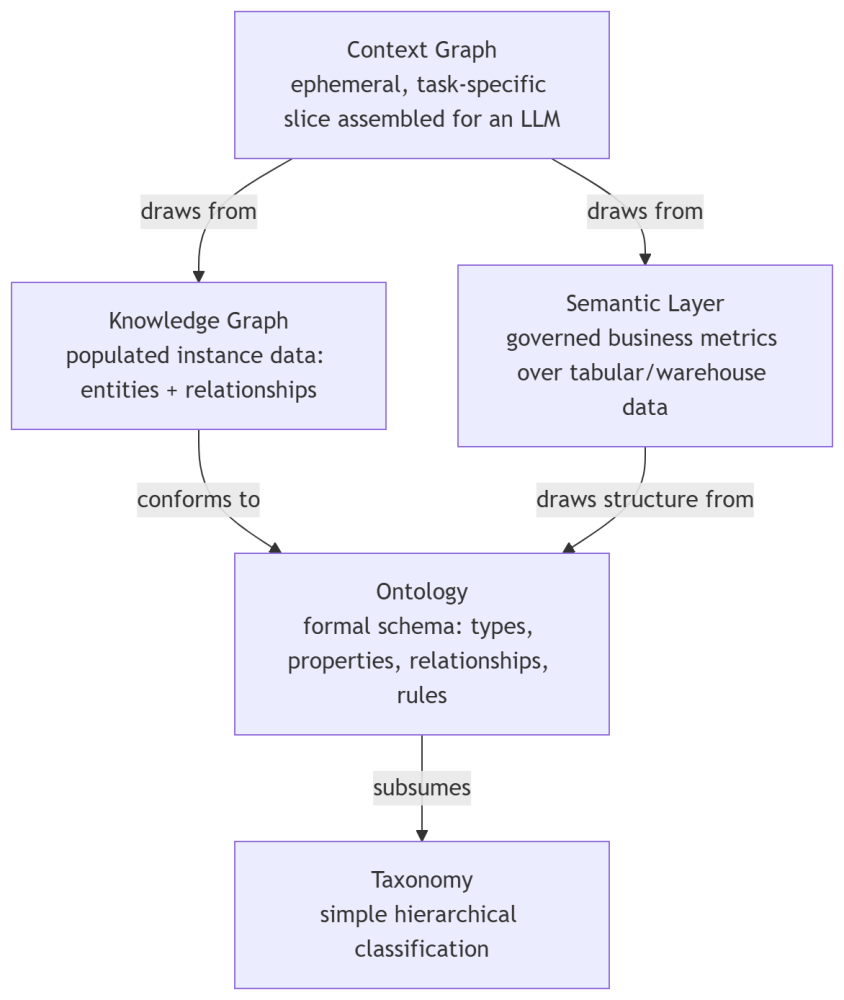
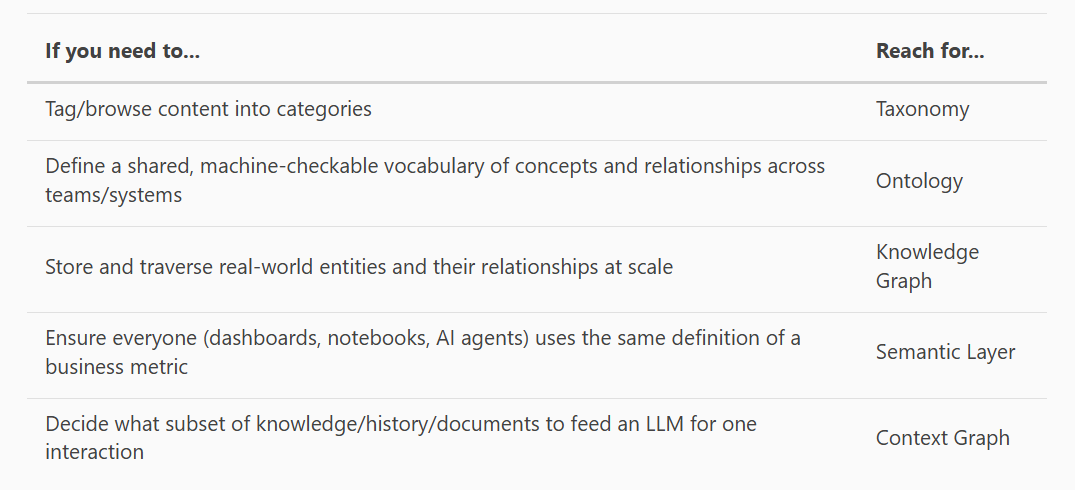
Именно поэтому современная архитектура аналитики постепенно смещается от идеи «дадим ИИ доступ к данным» к более зрелой идее: «дадим ИИ формализованную модель бизнеса, связанную с данными». В этом контексте особенно полезно разобраться, чем отличаются таксономия, онтология, граф знаний, семантический слой и Context Graph. Это не пять названий одного и того же. Они решают разные задачи и хорошо дополняют друг друга.
Ниже попробуем разобрать это без академической абстракции, но достаточно глубоко, чтобы было понятно, как подобная архитектура может работать в реальной компании и какое место в ней может занимать DataForge.
Почему доступ к таблицам еще не означает понимание бизнеса
Представим обычное корпоративное хранилище данных. В нем есть таблицы продаж, себестоимости, клиентов, магазинов, товаров и календаря. Технически все выглядит достаточно хорошо: таблицы имеют понятные связи, данные регулярно загружаются, разработчик может написать SQL и построить отчет. Если посмотреть на структуру такого DWH глазами базы данных, мы увидим сущности примерно следующего уровня: sales_amount, discount_amount, vat_amount, cost_amount, customer_id, product_id, store_id, operation_date.
Но бизнес-пользователь никогда не спрашивает: «Покажи мне сумму поля sales_amount из таблицы fct_sales». Он спрашивает: «Какая у нас выручка?», «Почему снизилась маржа?», «Что произошло с продажами в Северо-Западном регионе?», «Почему EBITDA ниже плана?».
И здесь начинается самая важная проблема. В компании слово «выручка» может означать совершенно разные расчеты. В одном случае это сумма отгрузок без НДС, в другом — продажи за вычетом возвратов, в третьем — признанная бухгалтерская выручка, в четвертом — управленческая выручка, скорректированная на бонусы и маркетинговые компенсации. Более того, разные подразделения могут использовать один и тот же термин по-разному.
Для человека, давно работающего в компании, значительная часть этой логики находится «в голове». Аналитик знает, что возвраты нужно брать из отдельной таблицы, скидки учитывать по дате продажи, а не по дате начисления, а внутренние перемещения необходимо исключать. Большая языковая модель этого не знает. Если ей показать только физическую структуру базы, она будет вынуждена угадывать смысл по именам таблиц и полей. Иногда угадает правильно, иногда нет. В демонстрации это может выглядеть впечатляюще, но для промышленной аналитики такой подход слишком ненадежен.
Отсюда возникает фундаментальный вопрос: где должна храниться бизнес-семантика корпоративных данных и как сделать ее доступной не только аналитикам, но и ИИ?
Таксономия: наводим порядок в понятиях
Самый простой уровень организации знаний — таксономия. Это иерархическая классификация понятий. Она отвечает на вопрос: к какой категории относится объект?
Например, в финансовой предметной области показатели можно организовать так: сначала разделить их на доходы, расходы, прибыльность, ликвидность и эффективность. Внутри прибыльности могут находиться валовая прибыль, операционная прибыль, EBITDA, чистая прибыль и различные коэффициенты маржинальности. В торговле товары можно разделить на категории, подкатегории, бренды и линейки. В логистике — на процессы закупки, транспортировки, складирования и последней мили.
Таксономия очень полезна, потому что она помогает навести порядок в большом количестве объектов. Если в корпоративном каталоге существует 5 000 показателей, без иерархии пользователь быстро теряется. Таксономия позволяет сказать: «Этот показатель относится к финансам, внутри финансов — к блоку прибыльности, внутри него — к операционной эффективности».
Но таксономия почти ничего не говорит о бизнес-логике. Она может сообщить, что EBITDA относится к группе показателей прибыльности, но не объяснит, как именно EBITDA рассчитывается в этой компании. Она может сказать, что товар «Ботинки мужские» относится к категории «Обувь», но не расскажет, какой поставщик его поставляет и в каких магазинах он продается.
Именно поэтому таксономия — хороший навигационный инструмент, но недостаточная основа для аналитического ИИ.
Онтология: описываем не список объектов, а устройство предметной области
Следующий уровень — онтология. Здесь мы уже не просто классифицируем понятия, а описываем какие типы сущностей существуют в предметной области и какими отношениями они могут быть связаны.
В розничной торговле онтология может определить такие сущности, как клиент, товар, заказ, магазин, поставщик, регион, сотрудник, показатель. Затем она задает отношения: клиент оформляет заказ, заказ содержит товар, магазин находится в регионе, товар поставляется поставщиком, показатель рассчитывается из других показателей, показатель анализируется по определенным измерениям.
Это важный шаг, потому что мы переходим от списка терминов к модели бизнеса.
Возьмем простой пример. В физической базе данных можно увидеть таблицы orders, customers, products, stores. Для разработчика понятно, что одна таблица соединяется с другой по идентификаторам. Но онтология может выразить это в бизнес-терминах: клиент совершает заказ, заказ содержит товар, заказ выполняется магазином, магазин принадлежит региону. Такой уровень значительно ближе к тому, как рассуждает человек.
Особенно интересны онтологии для ИИ, потому что они ограничивают пространство возможных интерпретаций. Если мы знаем, что «магазин находится в регионе», а «товар принадлежит товарной категории», то агенту уже сложнее придумать бессмысленную связь вроде «регион принадлежит товару».
В аналитике онтология может быть дополнена понятиями показателя, измерения, источника данных и отчета. Тогда появляются отношения вроде «показатель рассчитывается из показателя», «показатель использует измерение», «показатель получен из набора данных», «дашборд использует показатель».
Например, можно формально зафиксировать, что Gross Margin является показателем, рассчитывается из Revenue и COGS, относится к предметной области Finance и допускает анализ по товару, региону и каналу продаж. Уже этого достаточно, чтобы ИИ значительно лучше понимал структуру аналитической задачи.
KnowledgeGraph: когда схема наполняется реальными объектами
Онтология описывает правила мира, а Knowledge Graph, или граф знаний, наполняет этот мир конкретными объектами.
Если онтология говорит: «Товар поставляется поставщиком», то граф знаний может содержать конкретную связь: «Товар X поставляется компанией Y». Если онтология определяет, что магазин расположен в регионе, то граф знаний хранит: «Магазин № 18 находится в Санкт-Петербурге».
Для аналитики особенно полезен другой тип графа — граф бизнес-показателей и их происхождения. Например, EBITDA зависит от валовой прибыли и операционных расходов, валовая прибыль зависит от чистой выручки и себестоимости, чистая выручка — от валовых продаж, возвратов и скидок. При этом каждый нижний уровень может быть связан с конкретной физической таблицей DWH или источником ERP.
Такой граф позволяет пройти цепочку от бизнес-понятия до реальных данных. Если пользователь спрашивает: «Откуда взялась эта цифра EBITDA?», система может объяснить не только формулу, но и происхождение: какие показатели использовались, какие таблицы участвовали, из каких источников они были загружены.
Это уже намного ближе к тому, что нужно современному аналитическому агенту.
Почему граф зависимостей показателей особенно важен
В классическом BI многое строилось вокруг отчета. Аналитик создавал dashboard, в нем находились формулы, связи и вычисления. Пока отчет работал, пользователю было не так важно, где именно хранится логика.
Но с появлением ИИ мы хотим, чтобы одна и та же бизнес-логика использовалась сразу в нескольких местах: в BI-системе, в чат-аналитике, в автоматическом отчете, в API, в мобильном приложении и, возможно, в нескольких разных агентах.
В такой ситуации хранить формулу EBITDA отдельно в Power BI, отдельно в Qlik, отдельно в SQL и отдельно в промпте ИИ — крайне опасно. Через несколько месяцев все эти версии начинают расходиться.
Граф зависимостей показателей решает эту проблему. Он превращает показатели в управляемые объекты. Можно явно видеть, что показатель A использует B и C, показатель B зависит от D и E, а D берет данные из конкретного источника.
Это полезно сразу в нескольких сценариях. Первый — объяснимость. Можно ответить, из чего складывается показатель. Второй — анализ влияния. Если изменить формулу Revenue, можно определить, какие зависимые показатели, отчеты и витрины затронет изменение. Третий — автоматический анализ причин. Если EBITDA снизилась, агент может пройти вниз по дереву показателей и проверить, какой компонент дал основной вклад.
Именно здесь графовая модель начинает приносить не теоретическую, а прямую практическую пользу.
SemanticLayer: переводчик между бизнесом и физическими данными
Семантический слой — это слой, который связывает бизнес-понятия с физической моделью данных. Он отвечает на вопрос: что означает показатель и как его получить из корпоративных данных?
Допустим, бизнес говорит «чистая выручка». Для семантического слоя это не просто подпись на графике. Это объект с определением, формулой, доступными разрезами, правилами агрегации, временной логикой и связью с физическими источниками.
Например, семантическая модель может содержать следующее описание: «Чистая выручка — сумма продаж без НДС, возвратов и скидок. Рассчитывается по дате отгрузки. Может анализироваться по товару, клиенту, магазину, региону и каналу. Не включает тестовые продажи и внутренние перемещения».
Это уже очень богатый контекст. Если пользователь спрашивает: «Покажи выручку по регионам за июль», агенту не нужно самому решать, какое поле считать выручкой и какие фильтры применить. Он получает утвержденное определение.
Для классического BI семантический слой решал проблему согласованности. Например, чтобы выручка в Power BI и Tableau считалась одинаково. Для AI его роль становится еще важнее: он превращается в машиночитаемый справочник бизнес-смысла.
Именно поэтому сегодня semantic layer постепенно перестает быть внутренней частью конкретной BI-платформы. Он становится самостоятельным корпоративным активом.
Почему Text-to-SQL быстро упирается в ограничения
Одно из первых популярных применений LLM в аналитике — Text-to-SQL. Пользователь пишет: «Покажи продажи по регионам», модель генерирует SQL, запрос выполняется, результат возвращается пользователю.
Для простых случаев это работает удивительно хорошо. Но на корпоративных данных быстро проявляются ограничения.
Представим вопрос: «Почему прибыль снизилась в июле?»
Первое затруднение: какая именно прибыль? Валовая? Операционная? EBITDA? Чистая?
Второе: относительно чего снизилась — июня, июля прошлого года, плана?
Третье: по какой дате считать июль? По дате заказа, отгрузки, оплаты или бухгалтерского признания?
Четвертое: какие расходы включать?
Пятое: какие подразделения учитывать?
Обычная LLM пытается решить все это по названию полей и таблиц. Иногда ей помогает документация, иногда комментарии в DWH. Но это все равно очень ненадежный процесс.
Правильнее выглядит другой подход. Сначала система разрешает бизнес-термины через semantic layer: определяет, что пользователь имеет в виду под прибылью, получает утвержденную формулу и возможные разрезы. Только после этого строит запрос к данным.
То есть архитектура становится не Text-to-SQL, а Text-to-Semantics-to-SQL.
Это важный сдвиг. SQL остается техническим способом получить данные, но перестает быть главным интеллектуальным уровнем.
Один показательный пример: почему нельзя просто дать агенту всю схему
Допустим, в компании есть таблица продаж и таблица складских остатков. Пользователь спрашивает: «Покажи остатки по клиентам».
Языковая модель может технически соединить таблицы и вернуть результат. Запрос будет синтаксически правильным. Но с точки зрения бизнеса он может быть бессмысленным.
Складской остаток существует в разрезах товар × склад × дата. Клиент вообще не является естественным измерением запаса. Клиент связан с продажами, заказами и контрактами, но не с физическим остатком на складе.
Если semantic layer описывает допустимые измерения для каждого показателя, агент может понять проблему и ответить: «Остатки нельзя напрямую анализировать по клиентам. Я могу показать остатки по складам и товарам либо связать их с историей продаж клиентов косвенно».
Это принципиально более качественное поведение. Хороший аналитик именно так бы и поступил: сначала проверил, имеет ли запрос бизнес-смысл.
Grain: одна из самых недооцененных проблем AI Analytics
Еще более опасная тема — grain, то есть гранулярность данных.
Представим две таблицы. Первая содержит одну строку на каждую позицию чека. Вторая — одну строку на товар, склад и день. Если соединить их только по товару, каждая запись остатков может размножиться на сотни строк продаж. SQL будет корректным, данные вернутся, но итоговые суммы будут ошибочными.
Опытный DWH-разработчик знает такие ловушки. LLM без контекста — нет.
Поэтому зрелый semantic layer должен описывать не только названия метрик и измерений, но и гранулярность фактов, кардинальности связей, правила агрегации и совместимость разрезов. Фактически речь идет уже не о простом словаре показателей, а о полноценной аналитической модели.
Чем ближе мы подходим к промышленным AI-агентам, тем очевиднее становится: «дать модели схему базы» — слишком примитивная идея.
Context Graph: почему ИИ не нужен весь корпоративный граф сразу
Допустим, компания уже построила богатую семантическую модель. В ней десятки тысяч показателей, таблиц, отчетов и сущностей. Возникает следующий вопрос: нужно ли передавать все это в prompt агента?
Конечно, нет.
Пользователь спрашивает: «Почему валовая маржа Москвы снизилась в июле?». Для этого не нужны данные о HR, закупках офисной мебели, финансовых ковенантах и остатках запасных частей.
Агенту нужен маленький релевантный фрагмент корпоративного знания: Gross Margin, Revenue, COGS, возможно скидки, возвраты и закупочная стоимость; измерения регион, товар, канал, дата; фильтр Москва и выбранный период.
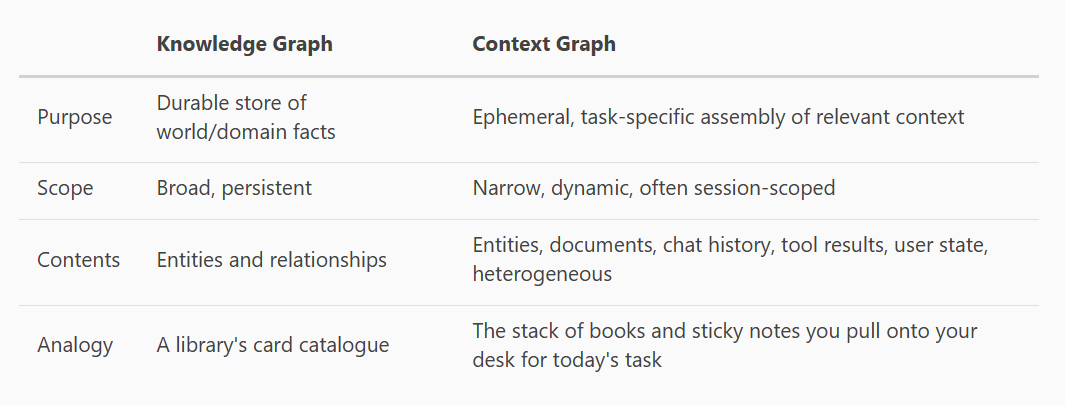
Именно такую временную рабочую модель удобно называть Context Graph. Это контекст, собранный для конкретной задачи.
Knowledge Graph может быть постоянным и огромным. Context Graph — маленьким и временным. Он существует столько, сколько нужно для выполнения вопроса.
Это очень похоже на работу хорошего аналитика. Когда его спрашивают про падение маржи, он не пытается вспомнить все данные компании. Он выделяет релевантные показатели, строит несколько гипотез и проверяет их.
Отвечать «почему» значительно сложнее, чем отвечать «сколько»
Большинство первых аналитических AI-продуктов хорошо показывают ответы на вопросы «сколько», «где», «когда». Например: «Какая была выручка в июле?» или «Какой регион показал максимальный рост?».
Настоящая ценность начинается с вопроса «почему».
Допустим, Gross Margin % снизилась с 31% до 27%. Само число мало что дает. Хороший аналитик будет раскладывать изменение на факторы. Возможно, выросли скидки. Возможно, изменился товарный mix и увеличилась доля низкомаржинальных категорий. Возможно, закупочная стоимость выросла быстрее цены. Возможно, увеличились возвраты.
Если агент знает структуру показателя и зависимости, он может использовать ее как план анализа. Сначала проверить Revenue и COGS, затем внутри Revenue — объем, цену, скидки и возвраты, внутри COGS — закупочную стоимость, логистику и производственные затраты.
Так граф показателей становится не просто справочником, а моделью reasoning.
Это одна из самых сильных идей всей архитектуры.
Как DataForge вписывается в эту картину
Теперь перейдем к практической части.
DataForge можно использовать как среду, в которой аналитическая семантика не хранится только в документации или голове разработчиков, а формализуется в виде объектов: показателей, формул, фактов, измерений, таблиц, витрин и зависимостей.
Это принципиально важно.
В большинстве компаний описание показателя обычно распределено по нескольким источникам. Название и бизнес-определение находятся в Excel или Confluence, формула — в SQL, источник — в документации DWH, реальные зависимости — в ETL-коде, а использование — внутри BI-системы. Собрать все это в единую картину сложно даже человеку.
DataForge позволяет приблизиться к другой модели: показатель становится самостоятельным объектом, который можно связать с другими показателями и с физическими данными.
Например, можно описать Gross Margin как показатель, зависящий от Net Revenue и COGS. Net Revenue, в свою очередь, может зависеть от Gross Sales, Returns и Discounts. Каждый из этих показателей можно связать с соответствующими фактами и источниками.
В результате из простой формулы постепенно возникает граф бизнес-логики.
Именно такой граф особенно интересен для ИИ.
DataForge как расчетный граф
Есть важная мысль: формула показателя сама по себе уже является графом.
Если EBITDA использует Gross Profit и OPEX, Gross Profit использует Revenue и COGS, а Revenue зависит от Sales, Returns и Discounts, мы получаем направленный граф зависимостей.
Его можно использовать в обе стороны.
Если мы движемся вверх по зависимостям, можно ответить: откуда появился показатель?
Если движемся вниз, можно ответить: что изменится, если изменить этот показатель?
Представим, что компания меняет методику расчета Net Revenue. Например, раньше определенные возвраты учитывались полностью, а теперь должны исключаться. Благодаря графу можно определить, какие зависимые показатели затронет изменение: Gross Margin, EBITDA, маржинальность по продуктам, финансовый dashboard и, возможно, модель прогноза.
Это уже полноценный impact analysis.
Для проекта DWH такой механизм полезен разработчикам. Для AI-агента — еще и источник объяснимости.
Пример: как агент может использовать DataForge при анализе падения прибыли
Представим, что коммерческий директор спрашивает:
«Почему операционная прибыль Москвы в июле снизилась относительно прошлого года?»
Хорошая архитектура может работать следующим образом.
Сначала агент ищет в семантической модели показатель «операционная прибыль». Он обнаруживает, что в компании используется официальный показатель Operating Profit и получает его определение.
Далее DataForge дает структуру расчета: Operating Profit зависит от Gross Profit и Operating Expenses. Gross Profit зависит от Net Revenue и COGS.
После этого агент понимает, какие показатели нужно проверить в первую очередь.
Допустим, данные показывают, что прибыль снизилась на 18%, выручка — на 4%, COGS выросла на 3%, а OPEX — на 9%.
Уже на этом уровне видно, что проблема не только в продажах. Агент идет глубже в OPEX и обнаруживает, что маркетинговые расходы выросли на 28%, тогда как зарплата и аренда изменились незначительно.
Затем он анализирует выручку и обнаруживает, что объем продаж даже вырос, но средняя цена снизилась, а доля скидок увеличилась.
Итоговый ответ может выглядеть как нормальная работа бизнес-аналитика: «Операционная прибыль снизилась прежде всего из-за роста маркетинговых расходов и ухудшения валовой маржи. Объем продаж увеличился, но эффект был перекрыт ростом скидок и себестоимости».
Это гораздо сильнее, чем просто показать пользователю SQL или таблицу.
DataForge как источник semantic metadata для агентов
Чтобы такая схема работала, агент должен получать данные о семантической модели программно.
Именно здесь особенно интересен API.
С точки зрения AI-инфраструктуры полезны операции вроде:
Тогда LLM не должна «помнить» устройство DWH в prompt. Она может получать релевантную семантику по запросу.
Это принципиально более масштабируемая архитектура.
Почему здесь интересен MCP
Для интеграции DataForge с агентами можно использовать MCP-подход.
В этом случае агент получает набор инструментов, например: «найти показатель», «получить формулу», «получить lineage», «получить доступные измерения», «показать downstream impact».
Пользователь спрашивает: «Почему снизилась рентабельность продаж?».
Агент сначала вызывает поиск метрики и понимает, какой корпоративный показатель соответствует фразе «рентабельность продаж». Затем получает его формулу, потом зависимости, после чего определяет, какие данные нужно запросить.
Важный принцип здесь такой: агент не придумывает бизнес-логику — он ее извлекает.
Это очень важное различие между зрелым корпоративным AI и красивой демонстрацией чат-бота.
GraphRAG для аналитики
Еще один интересный сценарий — GraphRAG.
Классический RAG обычно ищет документы по смысловой близости: пользователь задает вопрос, система находит похожие фрагменты текста и отправляет их в LLM.
Но в аналитике контекст можно формировать не только через поиск по документам, но и через обход графа показателей.
Например, пользователь спрашивает: «Почему упала прибыль?». Система определяет показатель, затем извлекает связанные с ним компоненты: Revenue, COGS, OPEX. Далее эти показатели могут привести к более глубокому уровню: Volume, Price, Discounts, Returns, Payroll, Marketing.
В результате контекст строится не по похожести текста, а по структуре бизнес-логики.
Это намного надежнее для аналитических задач.
Data Catalog, Semantic Layer и DataForge — не одно и то же
Важно не путать Data Catalog и Semantic Layer.
Data Catalog отвечает прежде всего на вопрос: какие данные у нас существуют?
Он может рассказать, что существует таблица продаж, кто ее владелец, какие поля в ней есть, когда она обновлялась, откуда загружается.
Semantic Layer отвечает на другой вопрос: что означает бизнес-понятие и как оно связано с данными?
Например, Data Catalog знает о таблице fct_sales. Semantic Layer знает, что показатель Revenue рассчитывается из конкретного поля этой таблицы с определенными фильтрами и правилами.
Идеальная архитектура не выбирает между ними. Они дополняют друг друга.
DataForge в этом контексте можно рассматривать как платформу, которая помогает формализовать именно аналитическую часть модели: показатели, формулы, факты, измерения и зависимости.
От Semantic Layer к SemanticOps
Когда семантическая модель становится важной частью корпоративной аналитики, возникает следующая проблема: ею нужно управлять.
Формула Revenue может измениться. Может поменяться владелец показателя. Может появиться новая версия расчета. Какие-то показатели могут быть deprecated. Какие-то изменения нужно согласовывать с финансовым директором.
То есть бизнес-семантика начинает жить жизнью, похожей на программный код.
Ее нужно версионировать, тестировать, сравнивать, согласовывать и контролировать влияние изменений.
Так постепенно возникает идея SemanticOps — управления жизненным циклом корпоративной семантики.
Это особенно важно в эпоху AI. Если неправильную формулу использовал один отчет, ошибка ограничена одним отчетом. Если неправильную формулу использует AI-agent, который отвечает сотням сотрудников, ошибка масштабируется мгновенно.
Поэтому AI не уменьшает значимость Data Governance. Он делает ее еще выше.
Где особенно полезен DataForge
Для DataForge здесь появляется интересная роль, выходящая за классическое проектирование DWH.
Его можно использовать как слой, где формализуется аналитическая модель бизнеса:
показатели → формулы → зависимости → измерения → факты → таблицы → витрины → источники.
Это уже почти готовая структура знаний для AI-агентов.
Особенно ценен тот факт, что речь идет не о вручную написанном описании, которое быстро устаревает, а о модели, связанной с реальной структурой DWH.
Именно поэтому DataForge потенциально может выступать не только как инструмент разработчика, но и как machine-readable semantic backbone корпоративной аналитики.
Какая архитектура в итоге получается
Если собрать все элементы вместе, получается довольно логичная архитектура.
На нижнем уровне находятся корпоративные источники и DWH.
Над ними — физическая модель данных.
Следующим уровнем становится DataForge, где описаны показатели, факты, измерения, формулы и зависимости.
Над этим может находиться semantic API или MCP-слой, через который агенты получают нужную информацию.
Еще выше — Context Builder, который для каждого пользовательского вопроса собирает только нужный фрагмент знаний.
И наконец, на верхнем уровне работает AI-agent, который уже выполняет анализ, формирует гипотезы и объясняет результаты.
Таким образом, LLM отвечает за reasoning, но не за определение корпоративной истины.
Именно это выглядит наиболее здравой архитектурой.
Главный вывод
Большая языковая модель сама по себе не решает проблему корпоративной аналитики. Более того, чем лучше LLM умеет писать SQL и уверенно формулировать ответы, тем опаснее использовать ее без качественной семантической модели: ошибка становится красивой, убедительной и масштабируемой.
Следующий этап развития корпоративного BI связан не столько с новым поколением языковых моделей, сколько с формализацией бизнес-смысла данных.
Таксономия помогает классифицировать понятия. Онтология описывает типы сущностей и отношения между ними. Knowledge Graph хранит конкретные связи. Semantic Layer связывает бизнес-понятия с физическими данными. Context Graph формирует маленький релевантный фрагмент знаний для конкретной задачи агента.
Аналитический AI начинает работать по-настоящему надежно только тогда, когда все эти уровни перестают существовать разрозненно.
Именно поэтому самая ценная часть современного DWH постепенно смещается от самих таблиц к формализованной модели бизнеса поверх этих таблиц.
В этом контексте DataForge можно рассматривать как один из инструментов для построения такой модели: он связывает показатели, формулы, измерения, факты и физические данные, формируя основу, которую одновременно могут использовать разработчики, BI-системы и AI-агенты.
Если раньше типовая корпоративная архитектура выглядела как:
источники → DWH → BI,
то новая архитектура все чаще будет выглядеть так:
источники → DWH → семантическая модель → BI / AI / приложения / агенты.
И именно семантическая модель становится общей системой координат, позволяющей человеку и машине одинаково понимать, что означают корпоративные данные.
DataForge - это система для визуального моделирования и проектирования структуры хранилищ данных (DWH). Он позволяет пользователям визуально проектировать таблицы фактов методом drag-and-drop, автоматически генерировать физическую и логическую модели данных, документировать бизнес-логику и определения атрибутов, а также генерировать DDL-скрипты для создания физической модели в реляционной СУБД.
DataForge © 2025-2026 Все права защищены.