BI-команды и инженеры по работе с данными
Проектируйте и развертывайте DWH без лишних усилий.
 В реестре Минцифры
Инновационный инструмент для совместного проектирования и моделирования хранилищ данных. Централизованное построение и сопровождение слоя DataMart. Визуальное моделирование, автоматическая генерация моделей и DDL-скриптов, документирование бизнес-логики.
К DataForge подключаются дополнительные ИИ-инструменты — ИИ-агенты и MCP-сервер: они автоматизируют создание РПИ (реестра показателей и измерений), превращают существующее DWH в описанный семантический слой и обеспечивают безопасный доступ ИИ-моделей к данным и метаданным.
DataForge - это система для визуального моделирования и проектирования структуры хранилищ данных (DWH) для enterprise-заказчиков.
Он позволяет пользователям визуально проектировать таблицы фактов методом drag-and-drop, автоматически генерировать физическую и логическую модели данных, документировать бизнес-логику и определения атрибутов, а также генерировать DDL-скрипты для создания физической модели в реляционной СУБД.
Благодаря дополнительным ИИ-агентам и MCP-серверу платформа не только проектирует хранилище, но и делает данные доступными для интеллектуального анализа: ИИ может формировать РПИ, отвечать на бизнес-вопросы, строить SQL-запросы и создавать HTML-дашборды на основе семантического слоя и фактических данных Data Mart. DataForge тем самым объединяет моделирование, семантику и ИИ-аналитику в одном решении.

Этот ИИ-агент автоматически формирует реестр показателей и измерений на основе существующих технических артефактов, включая DDL-скрипты баз данных. Алгоритм анализирует структуру таблиц, типы данных, связи и ключи, извлекая названия схем, таблиц и источников, а также сортируя атрибуты по категориям «Показатель» и «Измерение». Благодаря контекстному анализу агент способен не только разобрать структуру, но и интерпретировать смысл данных, создавая удобочитаемые бизнес-описания автоматически.
Как формируется РПИ →MCP-сервер выполняет роль универсального связующего звена между корпоративными данными, наполненными полезными метаданными из DataForge, и языковыми моделями (LLM), которые используют эти данные для анализа, генерации витрин, построения моделей или формирования отчётов. MCP обеспечивает безопасный и стандартизированный доступ к семантическому слою, структуре данных и содержащимся в DWH хранилищам, создавая единую точку взаимодействия между инфраструктурой данных и ИИ-агентами.
GitHub →ИИ-агент для диалоговой работы с корпоративными данными. Пользователь задаёт бизнес-вопрос на естественном языке, а агент самостоятельно определяет, какие данные нужны для ответа, обращается к семантическому слою DataForge через MCP Gateway, при необходимости исследует структуру базы данных, формирует SQL-запрос, проверяет результат и возвращает готовый аналитический ответ. Агент может объяснять показатели, строить таблицы и графики, находить отклонения, сравнивать периоды, выявлять лидеров и аутсайдеров, формировать краткие выводы и предлагать follow-up вопросы для продолжения анализа.
Как работает Analyst Agent →Одна платформа для всех этапов — от описания требований до сопровождения витрин.
Проектируйте и развертывайте DWH без лишних усилий.
Поддерживают унифицированные и масштабируемые модели данных.
Определяют показатели и измерения для аналитики.
Единый реестр показателей помогает управлять формулами, ускорять разработку витрин и снижать риск расхождений в корпоративной отчетности.
Показатели описываются один раз и переиспользуются во всех витринах, отчетах и BI-системах.
Изменение показателей и измерений выполняется через настройку реестра без переписывания SQL и ETL.
Бизнес и разработчики работают с едиными определениями показателей.
Аномалии и ошибки обнаруживаются до того, как попадут в отчетность.
Подрядчики и аналитики используют готовые показатели, не воспроизводя бизнес-логику вручную.
Машиночитаемый слой показателей и правил расчета позволяет ИИ-агентам формировать ответы на основе точных данных и единой бизнес-логики.
DataForge поставляется по годовой подписке. Для знакомства доступен free trial с ограниченным функционалом.
Типы лицензий:
Для корпоративных внедрений условия рассчитываются индивидуально.
| Возможности лицензии | Аналитик | Разработчик |
|---|---|---|
| Просмотр проектов и их содержимого | ✓ | ✓ |
| Генерация, просмотр и копирование SQL | ✓ | ✓ |
| Проверка и обновление подключений | ✓ | ✓ |
| Выполнение SQL для таблиц фактов и витрин | ✓ | ✓ |
| Создание, редактирование и удаление витрин | ✓ | ✓ |
| Редактирование РПИ | — | ✓ |
| Создание, редактирование и удаление таблиц фактов | — | ✓ |
| Управление версиями и подключениями | — | ✓ |
| Создание проектов, настройка доступа, передача владения | — | ✓ с ролью Проджект-менеджер или Администратор |
| Управление пользователями и настройками компании, системный журнал | — | ✓ с ролью Администратор |
При роли Наблюдатель лицензия «Аналитик» даёт только первые две строки таблицы.
Способ поставки, состав дистрибутива и системные требования — в блоке «Системные требования и развёртывание».
Опишите ключевые показатели, измерения и связи между ними.
Соберите таблицы фактов и справочники на наглядной схеме, перетаскивая элементы мышью.
SQL-скрипты создаются автоматически, а витрины появляются в хранилище без ручного программирования.
Бизнес-требования, модели данных и реальные базы данных остаются согласованными.
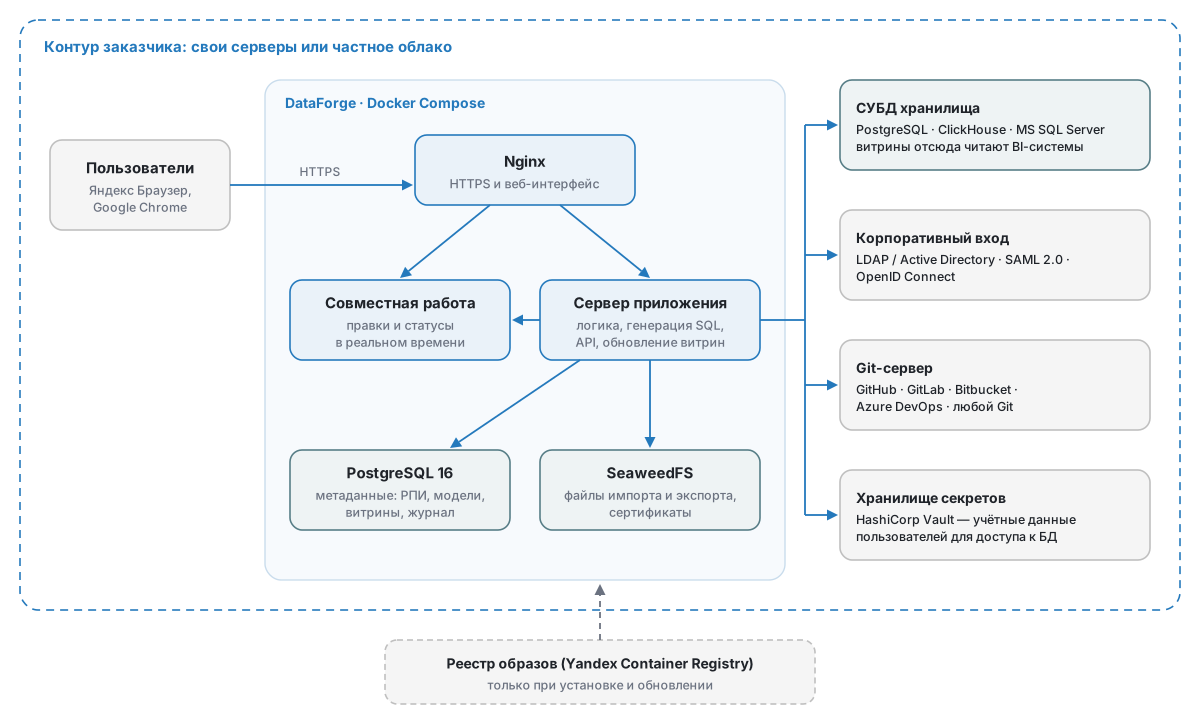
DataForge работает на ваших серверах или в частном облаке. Данные и метаданные не покидают контур компании, а для работы не нужны облачные сервисы поставщика.
В поставку входят архив с конфигурацией Docker Compose, доступ к реестру образов, лицензионный файл и документация.
| Сервер (на одну установку) | 4 vCPU от 2,0 ГГц, 8 ГБ ОЗУ, 100 ГБ SSD |
| Операционная система | Любая ОС с Docker. Российские: Astra Linux, РЕД ОС, ALT Linux. Зарубежные: Ubuntu, Debian и другие дистрибутивы Linux |
| Контейнеризация | Docker Engine 19.03+ и Docker Compose 1.28+ (серверы) или Docker Desktop 3.0+ |
| Рабочие места | Браузер: последние версии Яндекс Браузера или Google Chrome. Устанавливать ничего не нужно |
| СУБД для подключения | PostgreSQL (в том числе Postgres Pro и Jatoba), ClickHouse, Microsoft SQL Server |
| Интернет | Для работы не нужен. Доступ к реестру образов нужен только при установке и обновлении |
Linux с Docker — свой или в частном облаке.
Скрипт настройки сам пропишет адрес сервера.
Свой сертификат, автоматический Let's Encrypt или самоподписанный.
База метаданных создаётся и обновляется автоматически.
Загрузите лицензию, настройте вход через LDAP/AD, SAML или OpenID Connect либо пригласите сотрудников по почте.
Утилита обновления для Linux и Windows предлагает версию и сохраняет настройки; резервная копия базы — одной командой.
Главное, что умеет DataForge, — на скриншотах из продукта. Щёлкните по скриншоту, чтобы открыть его в полном размере.
Единые определения показателей для бизнеса и ИТ.
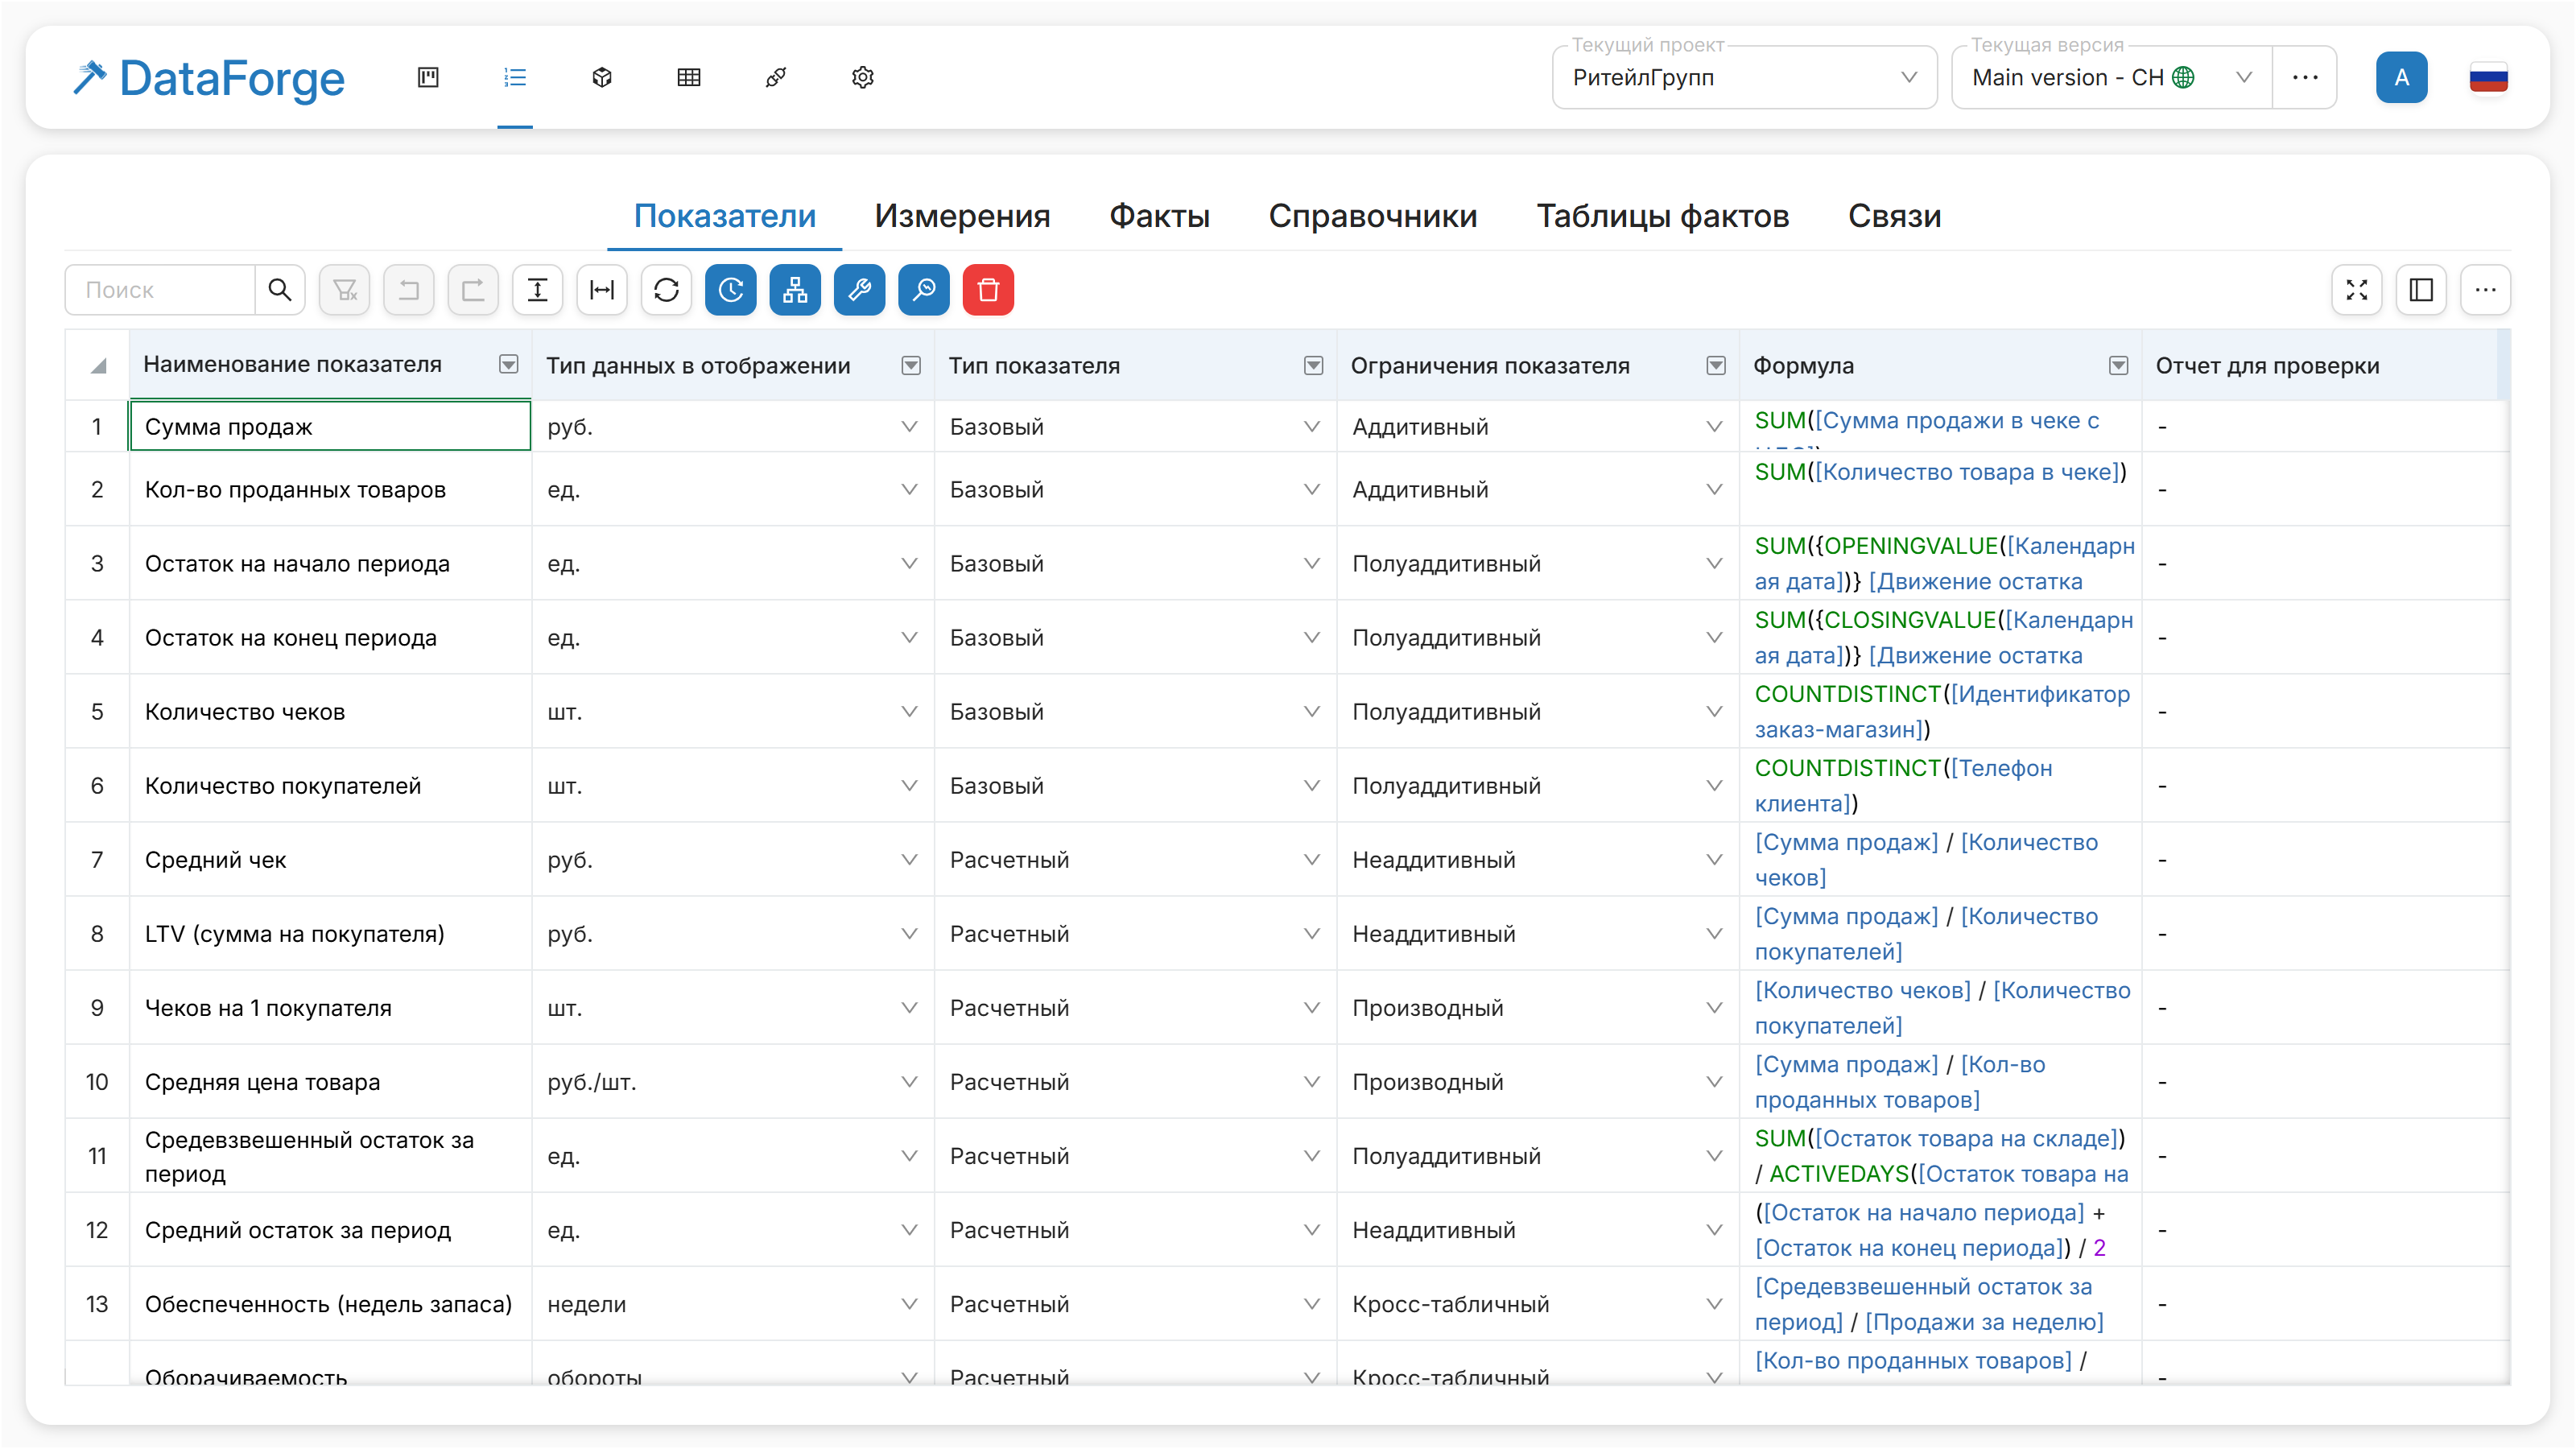
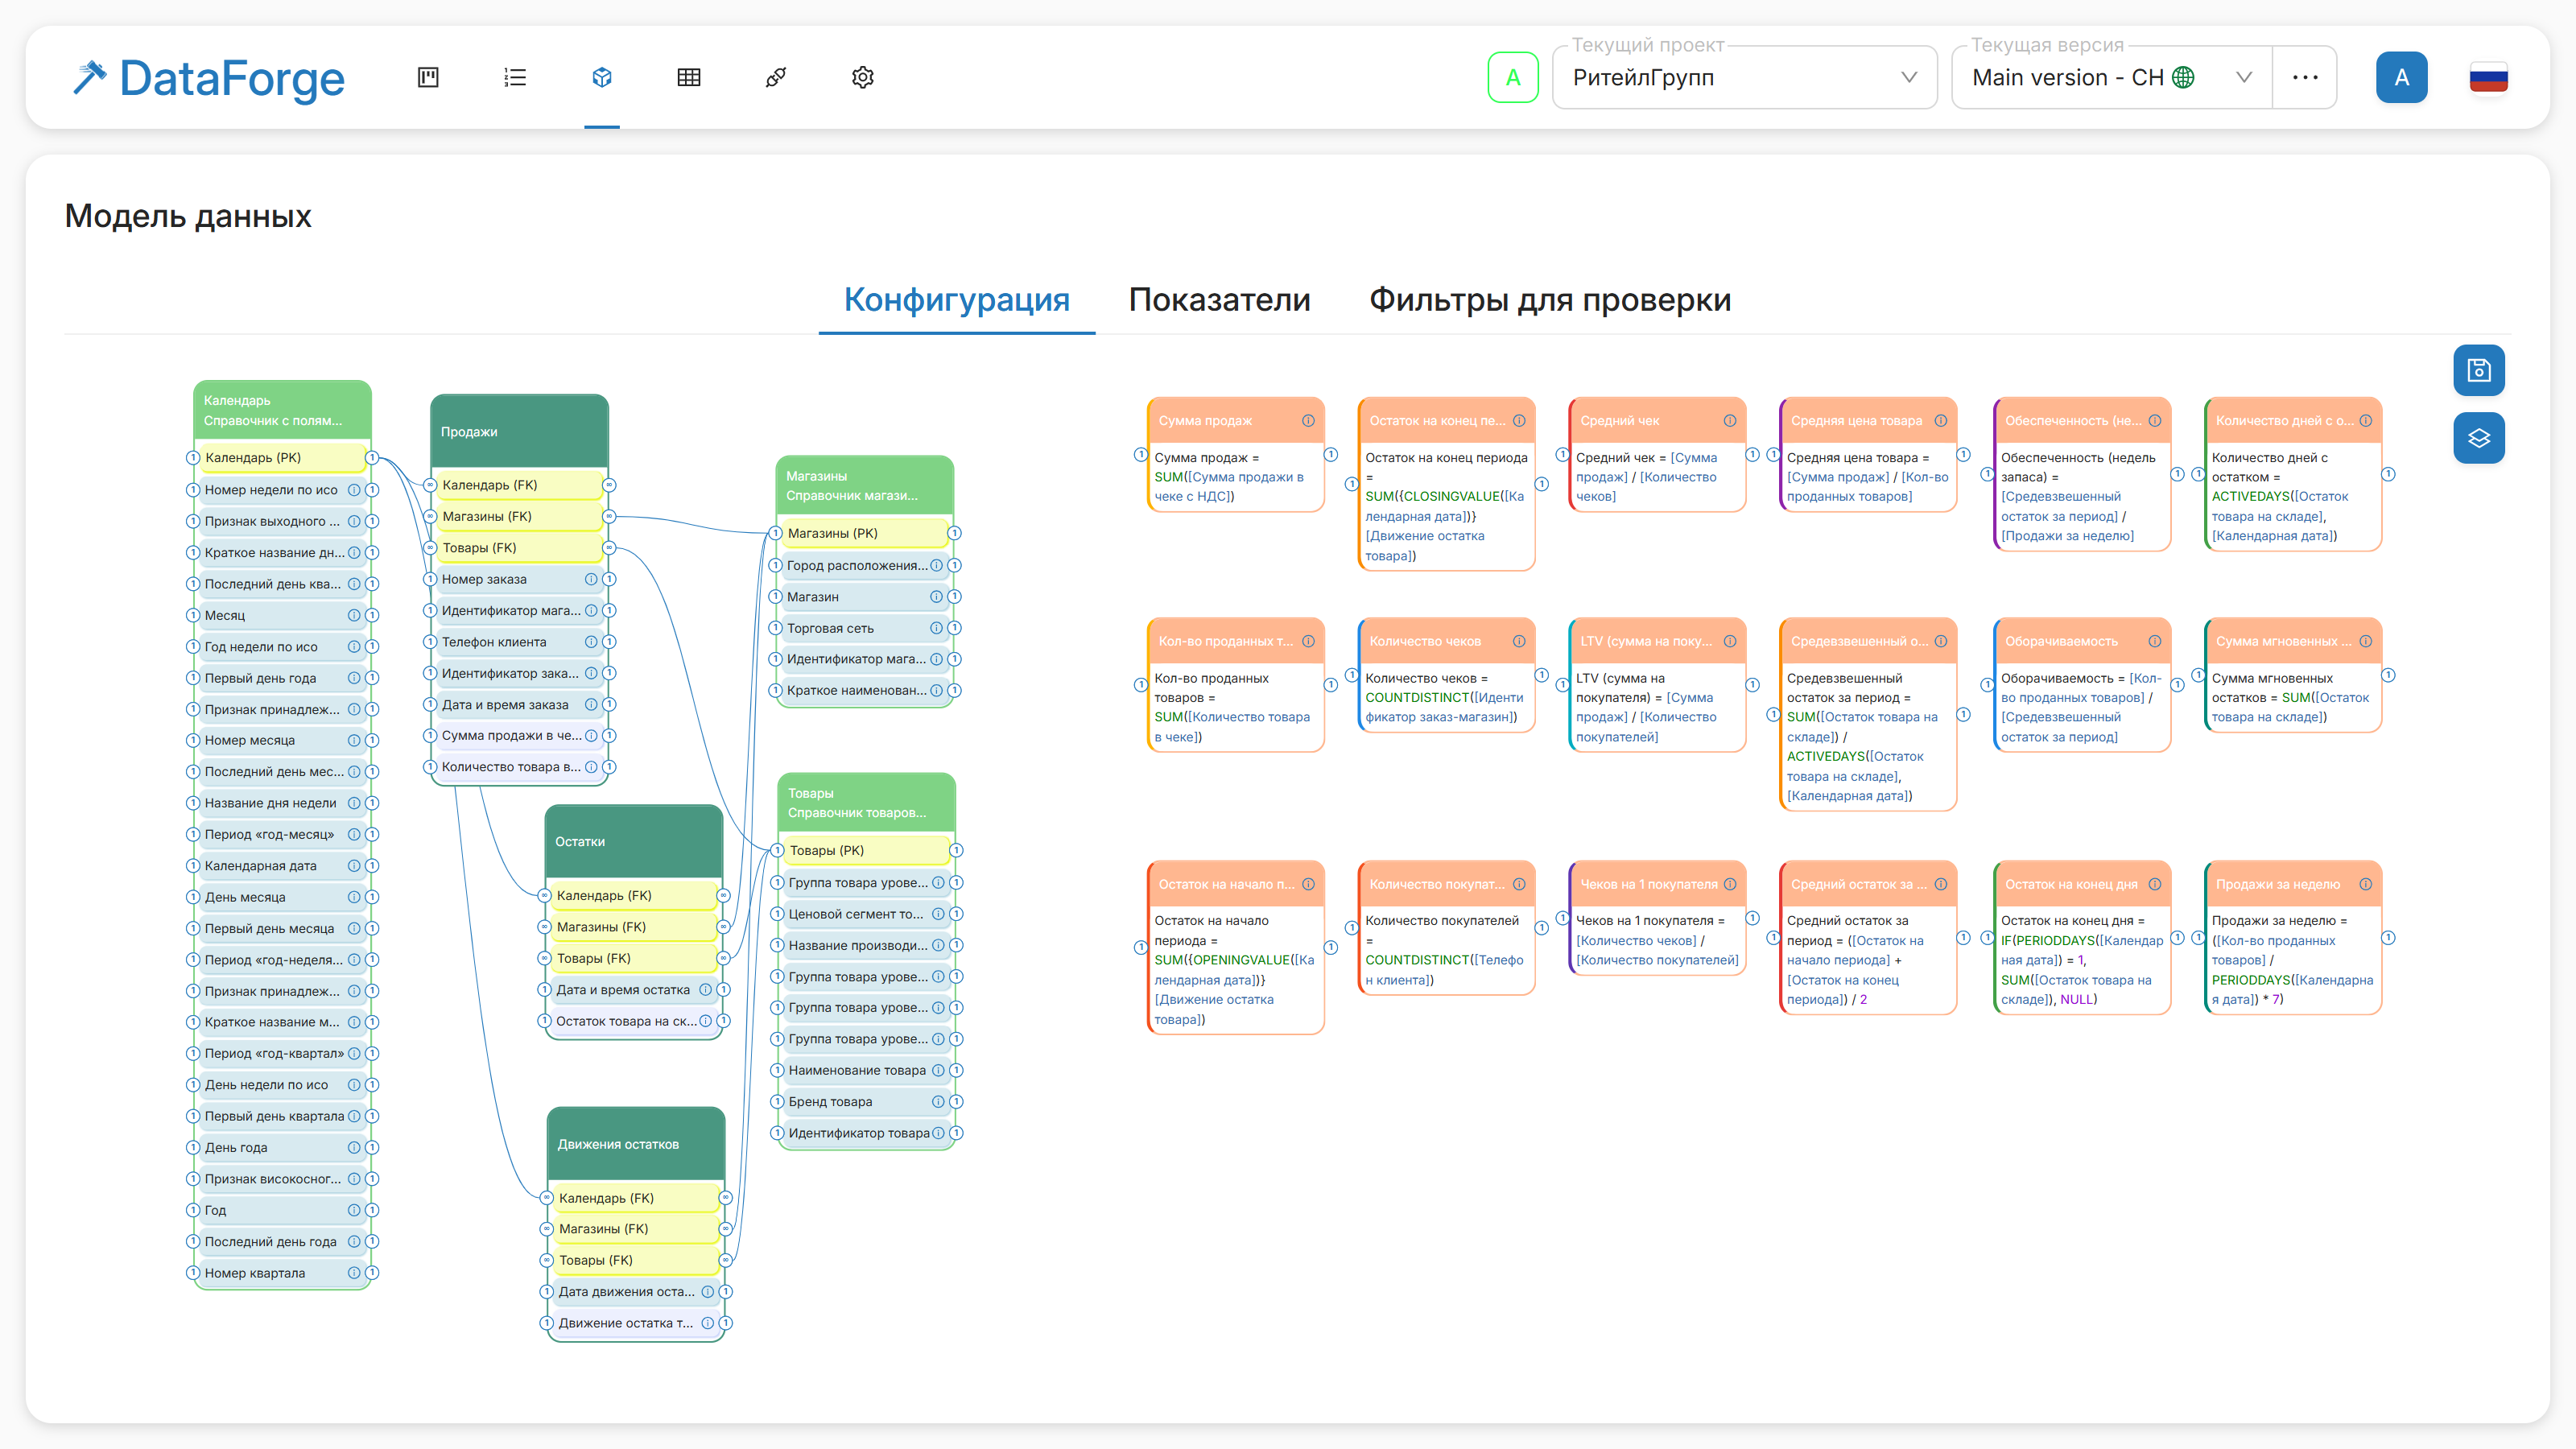
Показатели, измерения, факты и справочники описываются в одной таблице, привычной по Excel. У каждого показателя — единое определение, формула и источник, поэтому бизнес и ИТ работают с одними и теми же цифрами.
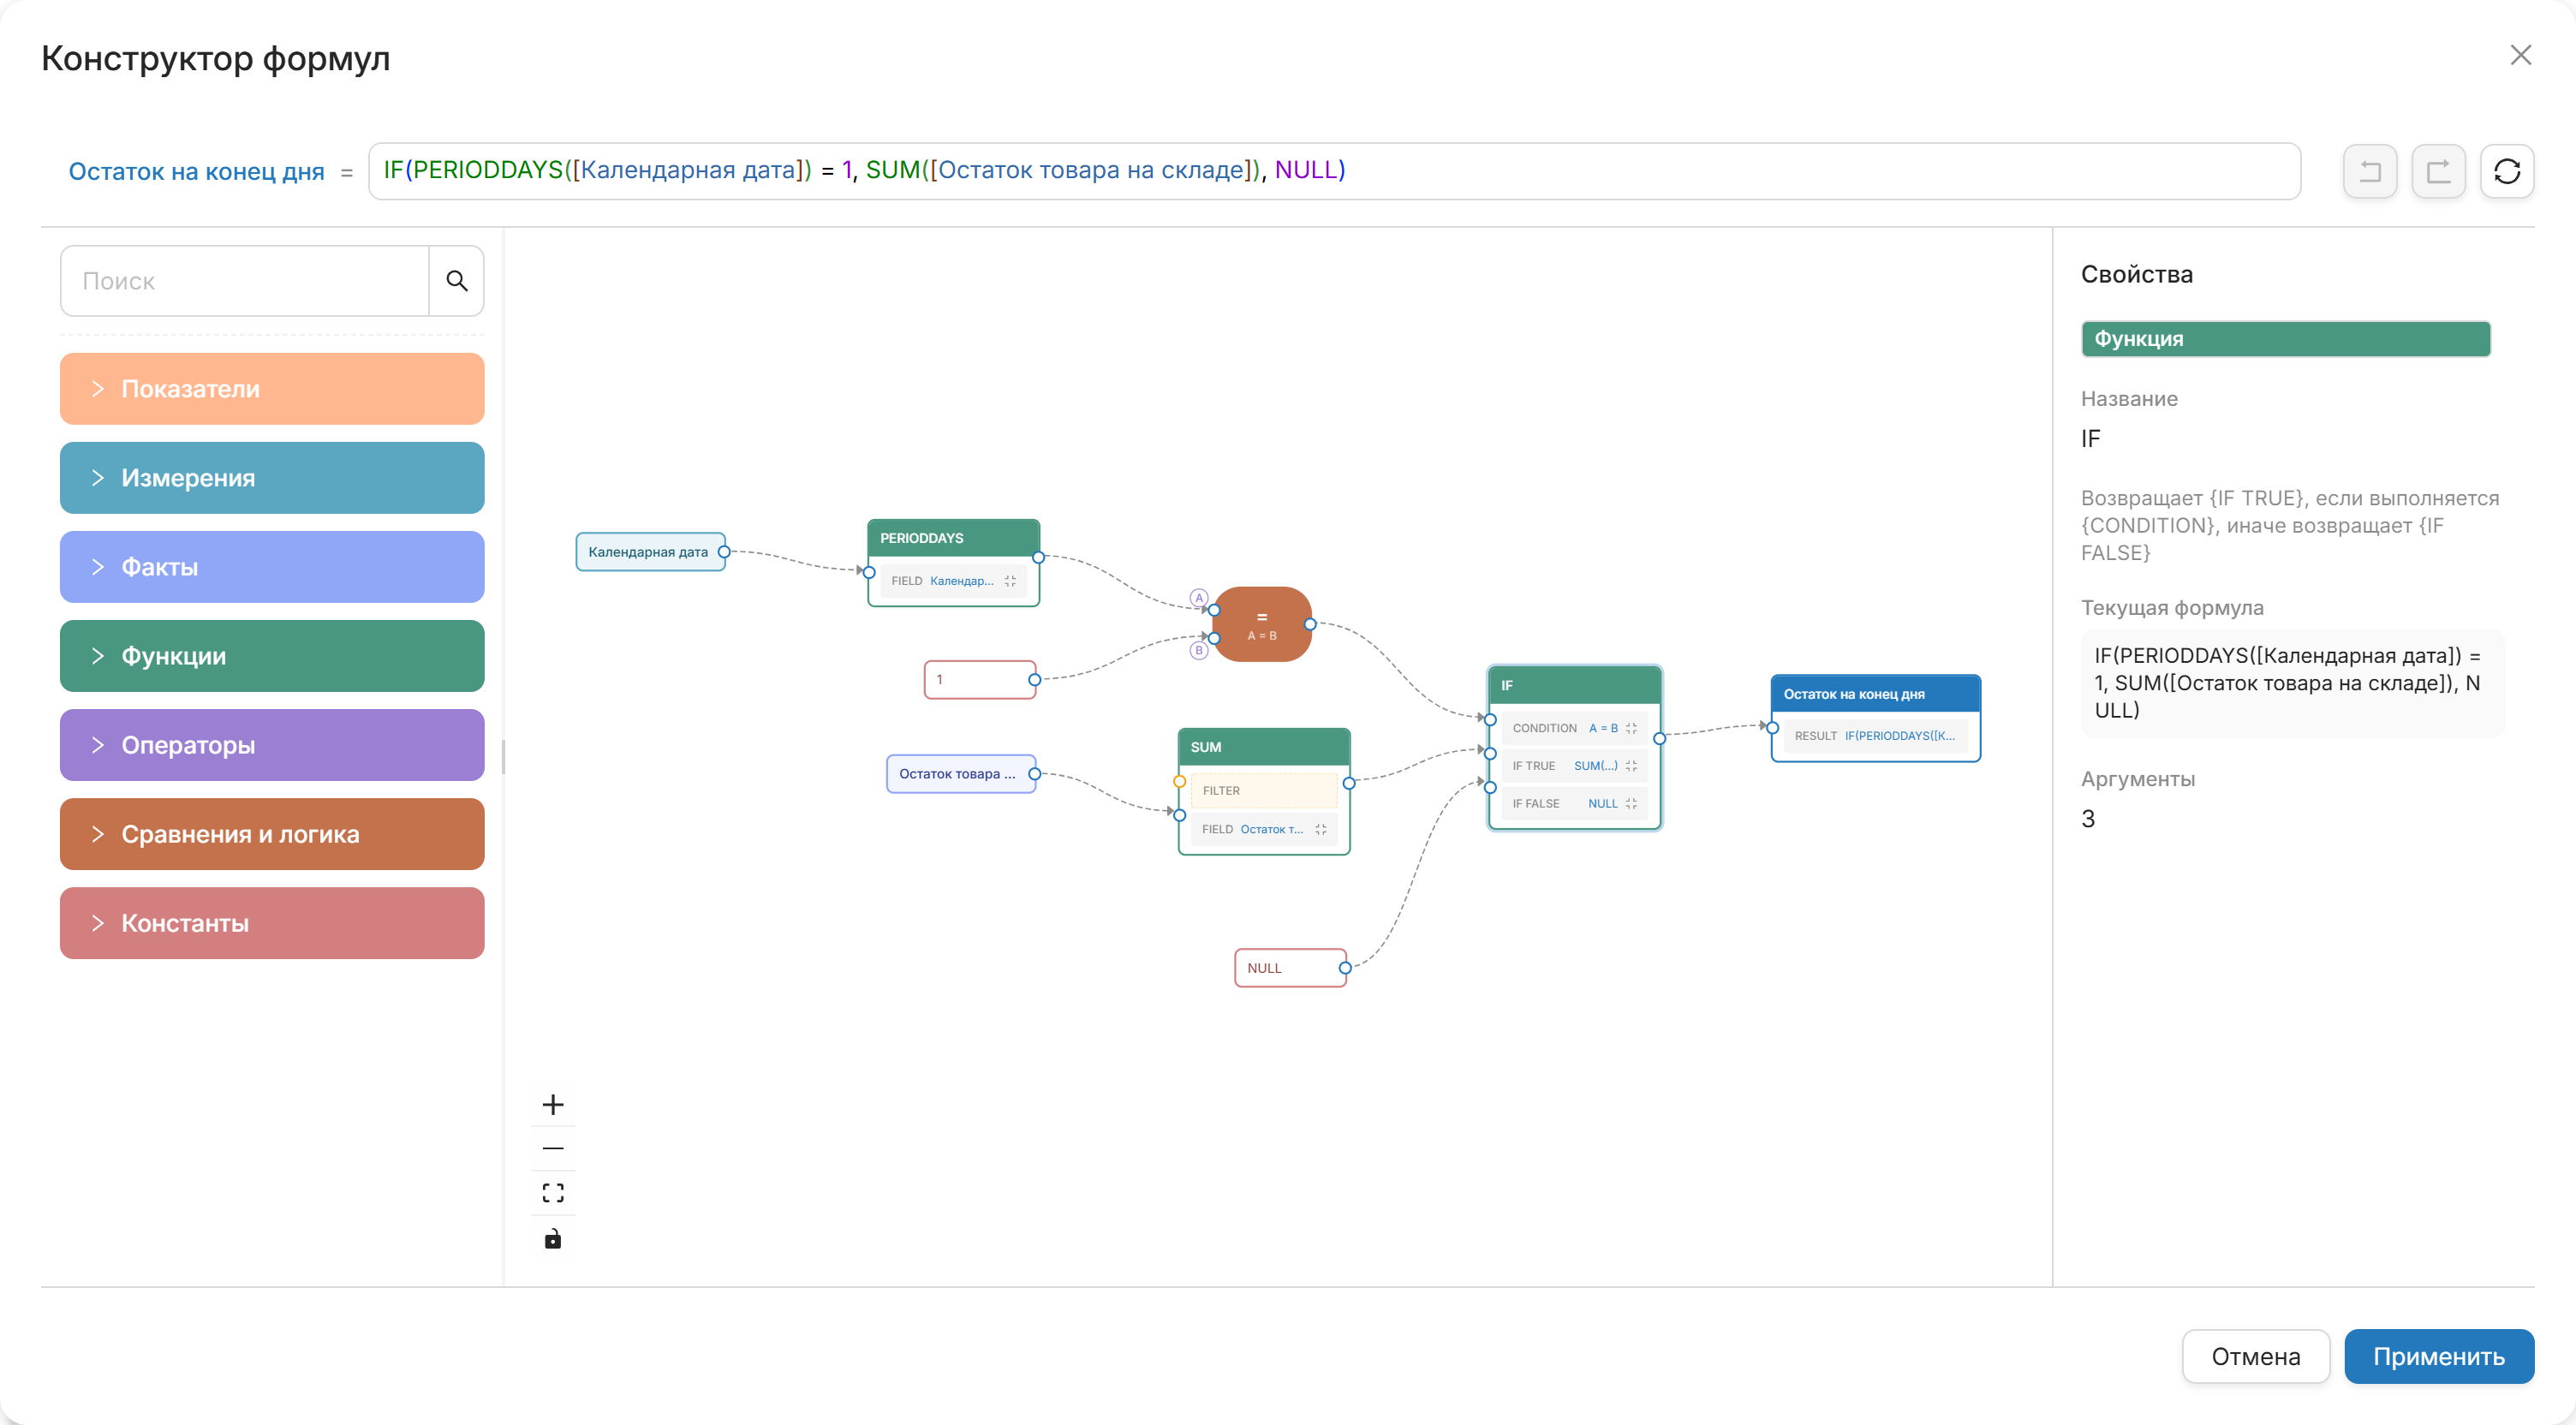
Сложная формула показателя открывается как схема связанных блоков, и схема синхронна с текстом: меняете одно — меняется другое. Аналитик собирает расчёт перетаскиванием, а не вспоминает синтаксис.
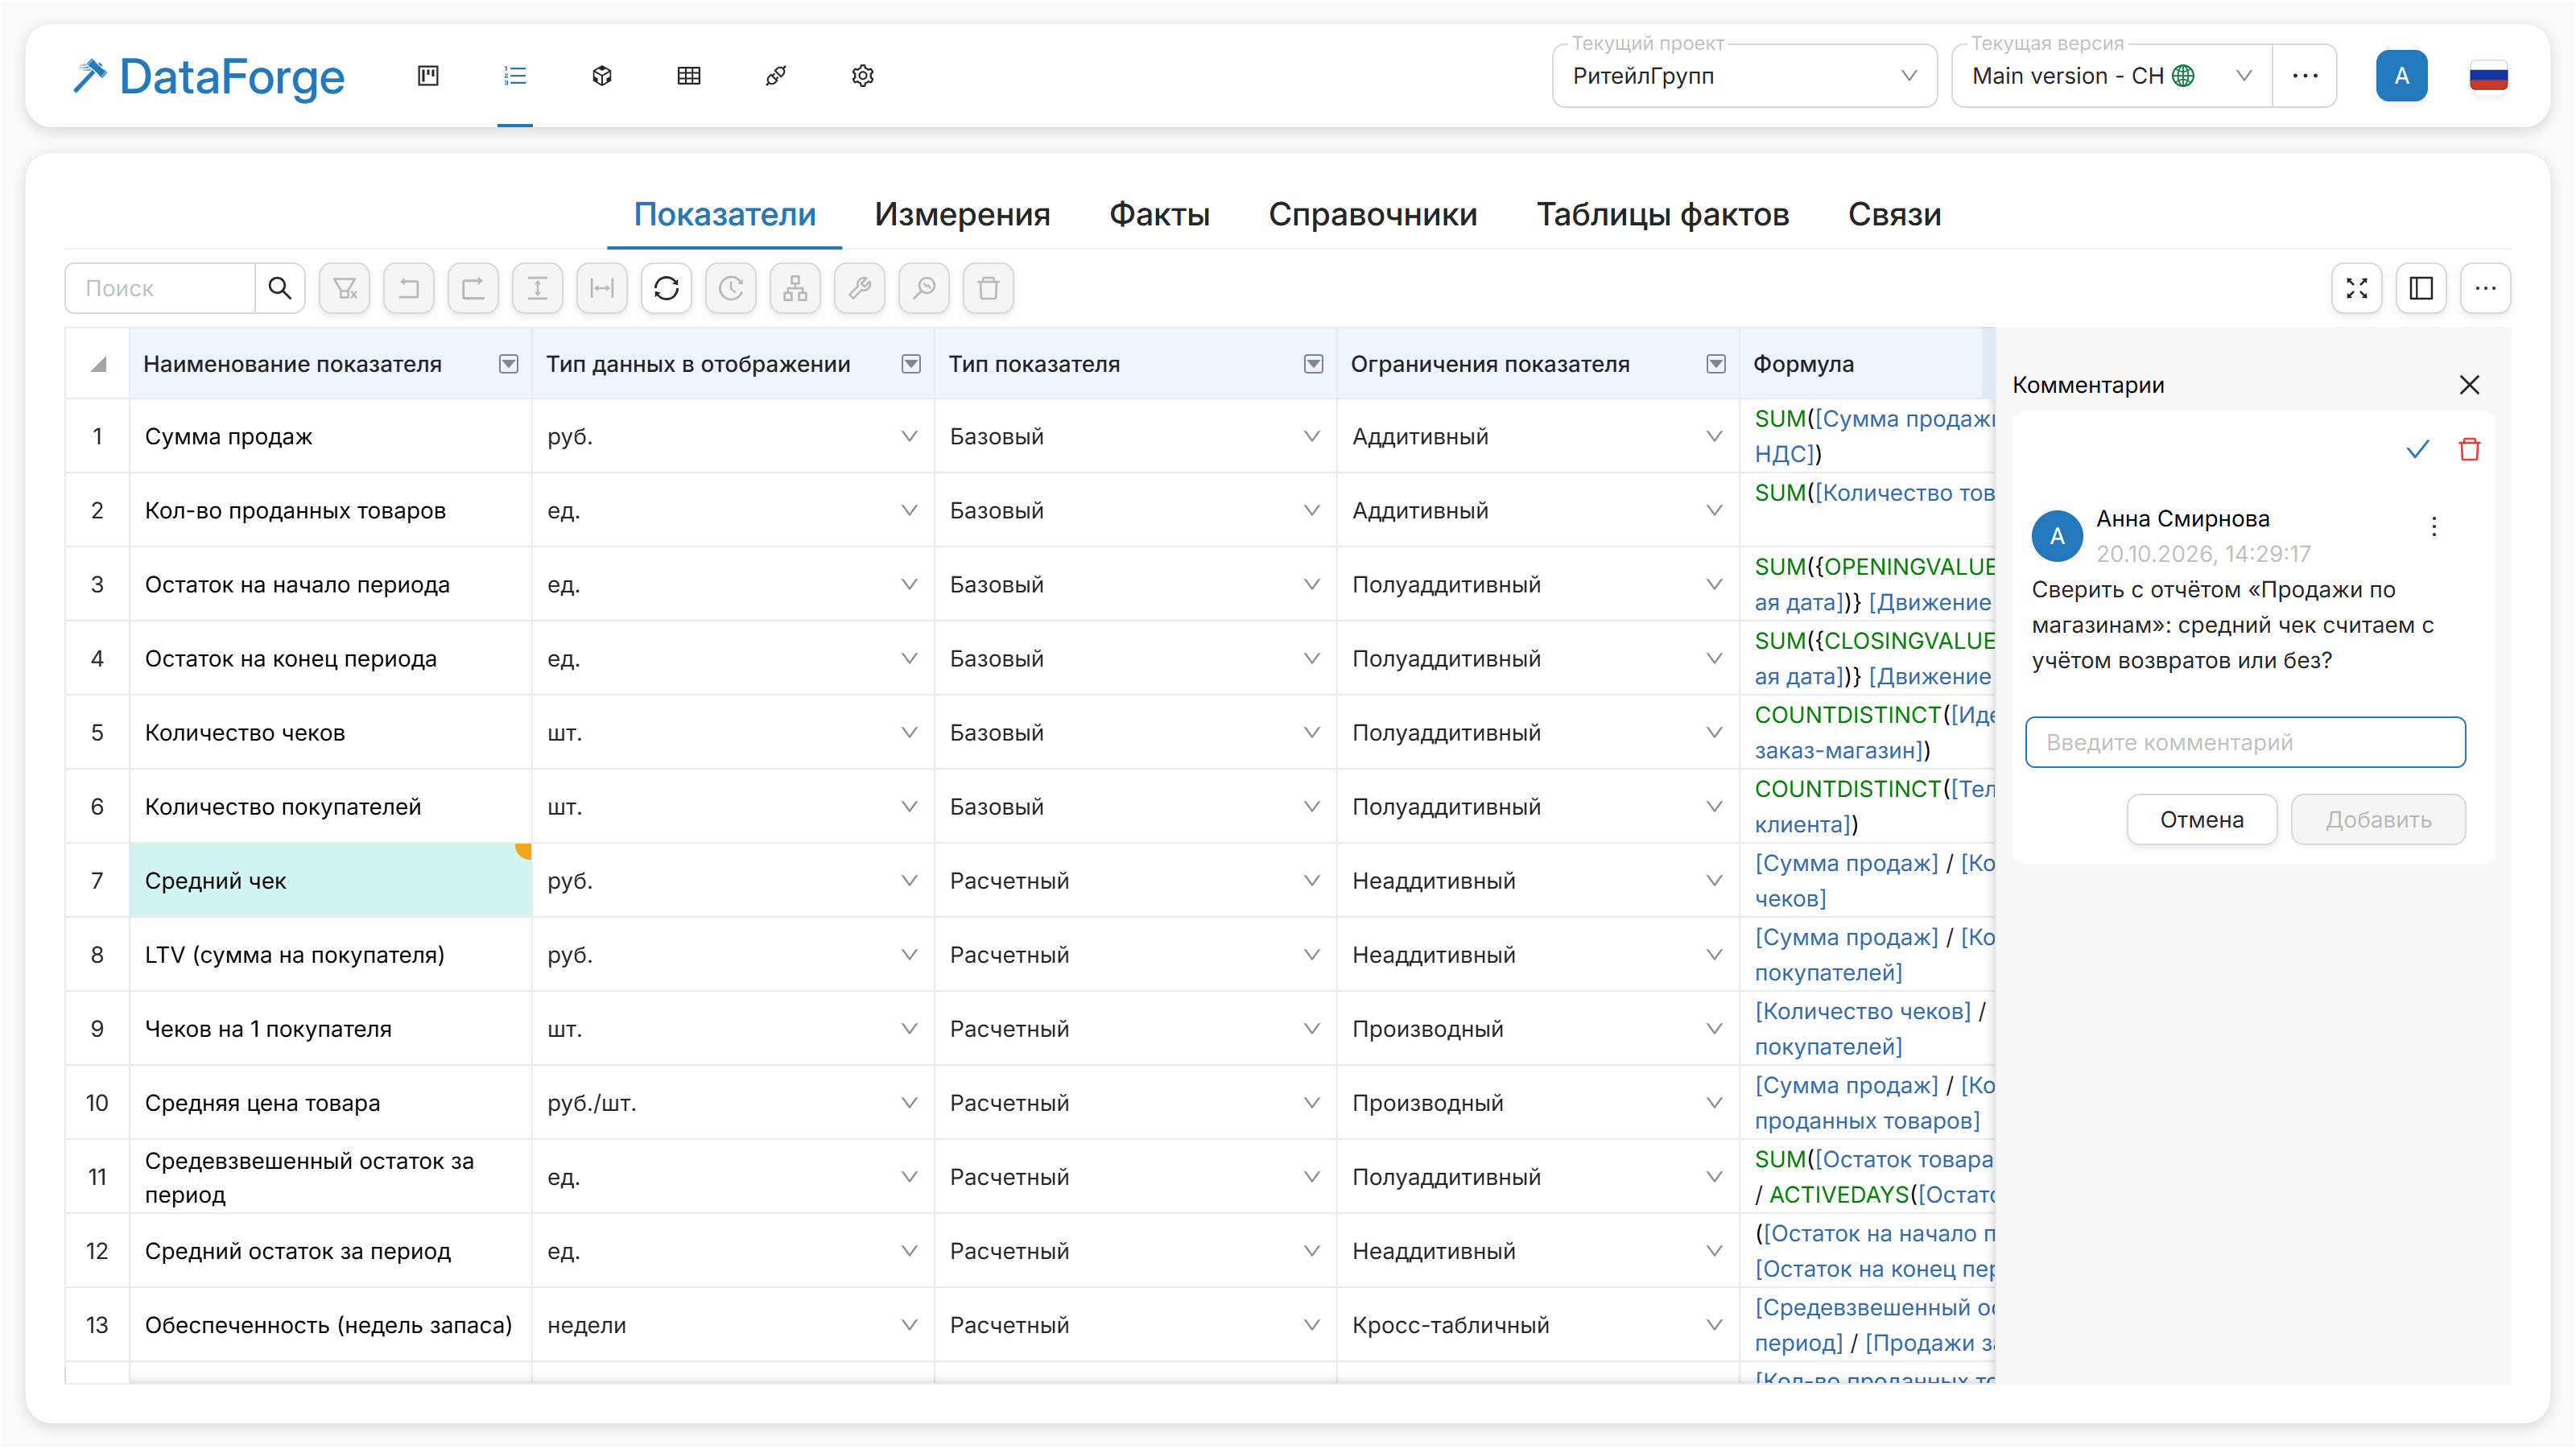
Бизнес-аналитик, инженер данных и BI-разработчик редактируют реестр одновременно и сразу видят правки друг друга. Вопрос к показателю обсуждается прямо в ячейке — не в почте и не в чате.
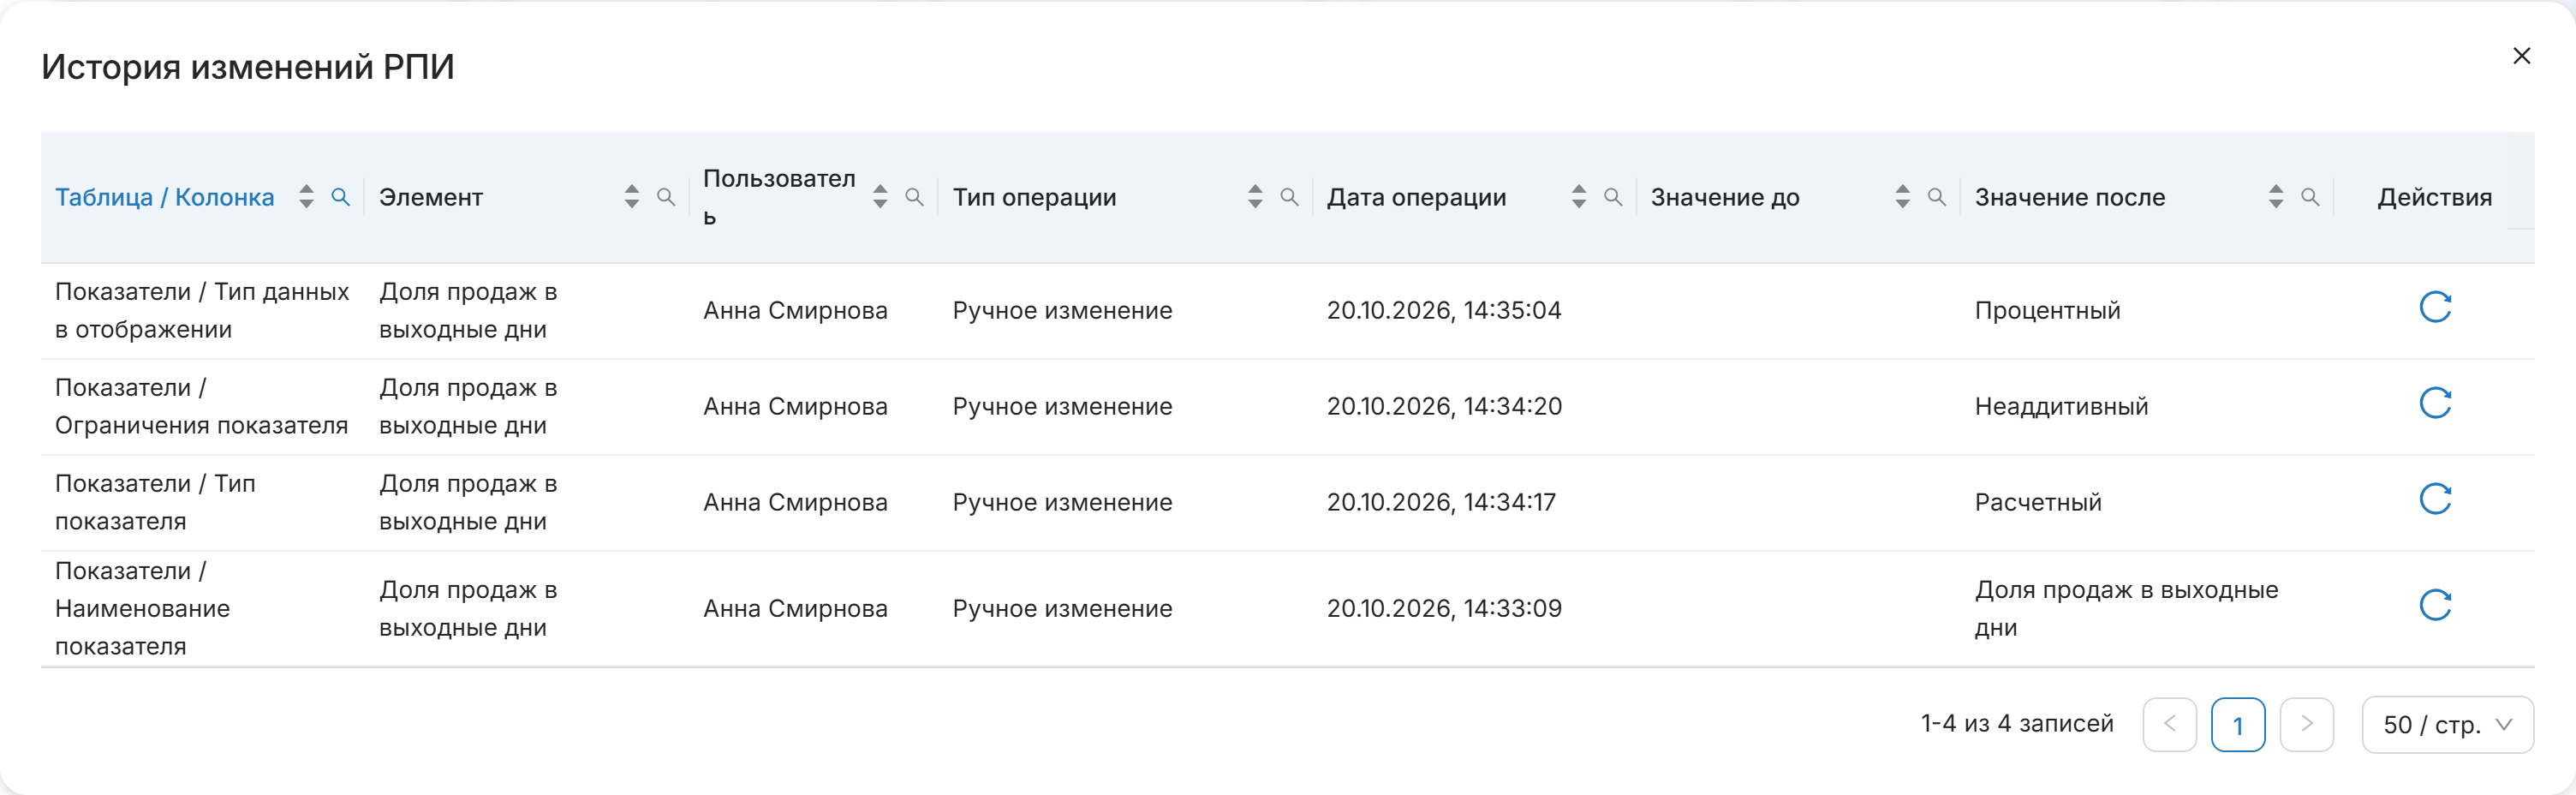
DataForge запоминает каждое изменение в реестре: кто, что, когда и каким способом изменил. Если цифра в отчёте вдруг изменилась, причина находится за минуты, а ошибочная правка отменяется в один щелчок.
От реестра до готовой витрины в хранилище — без ручного SQL.
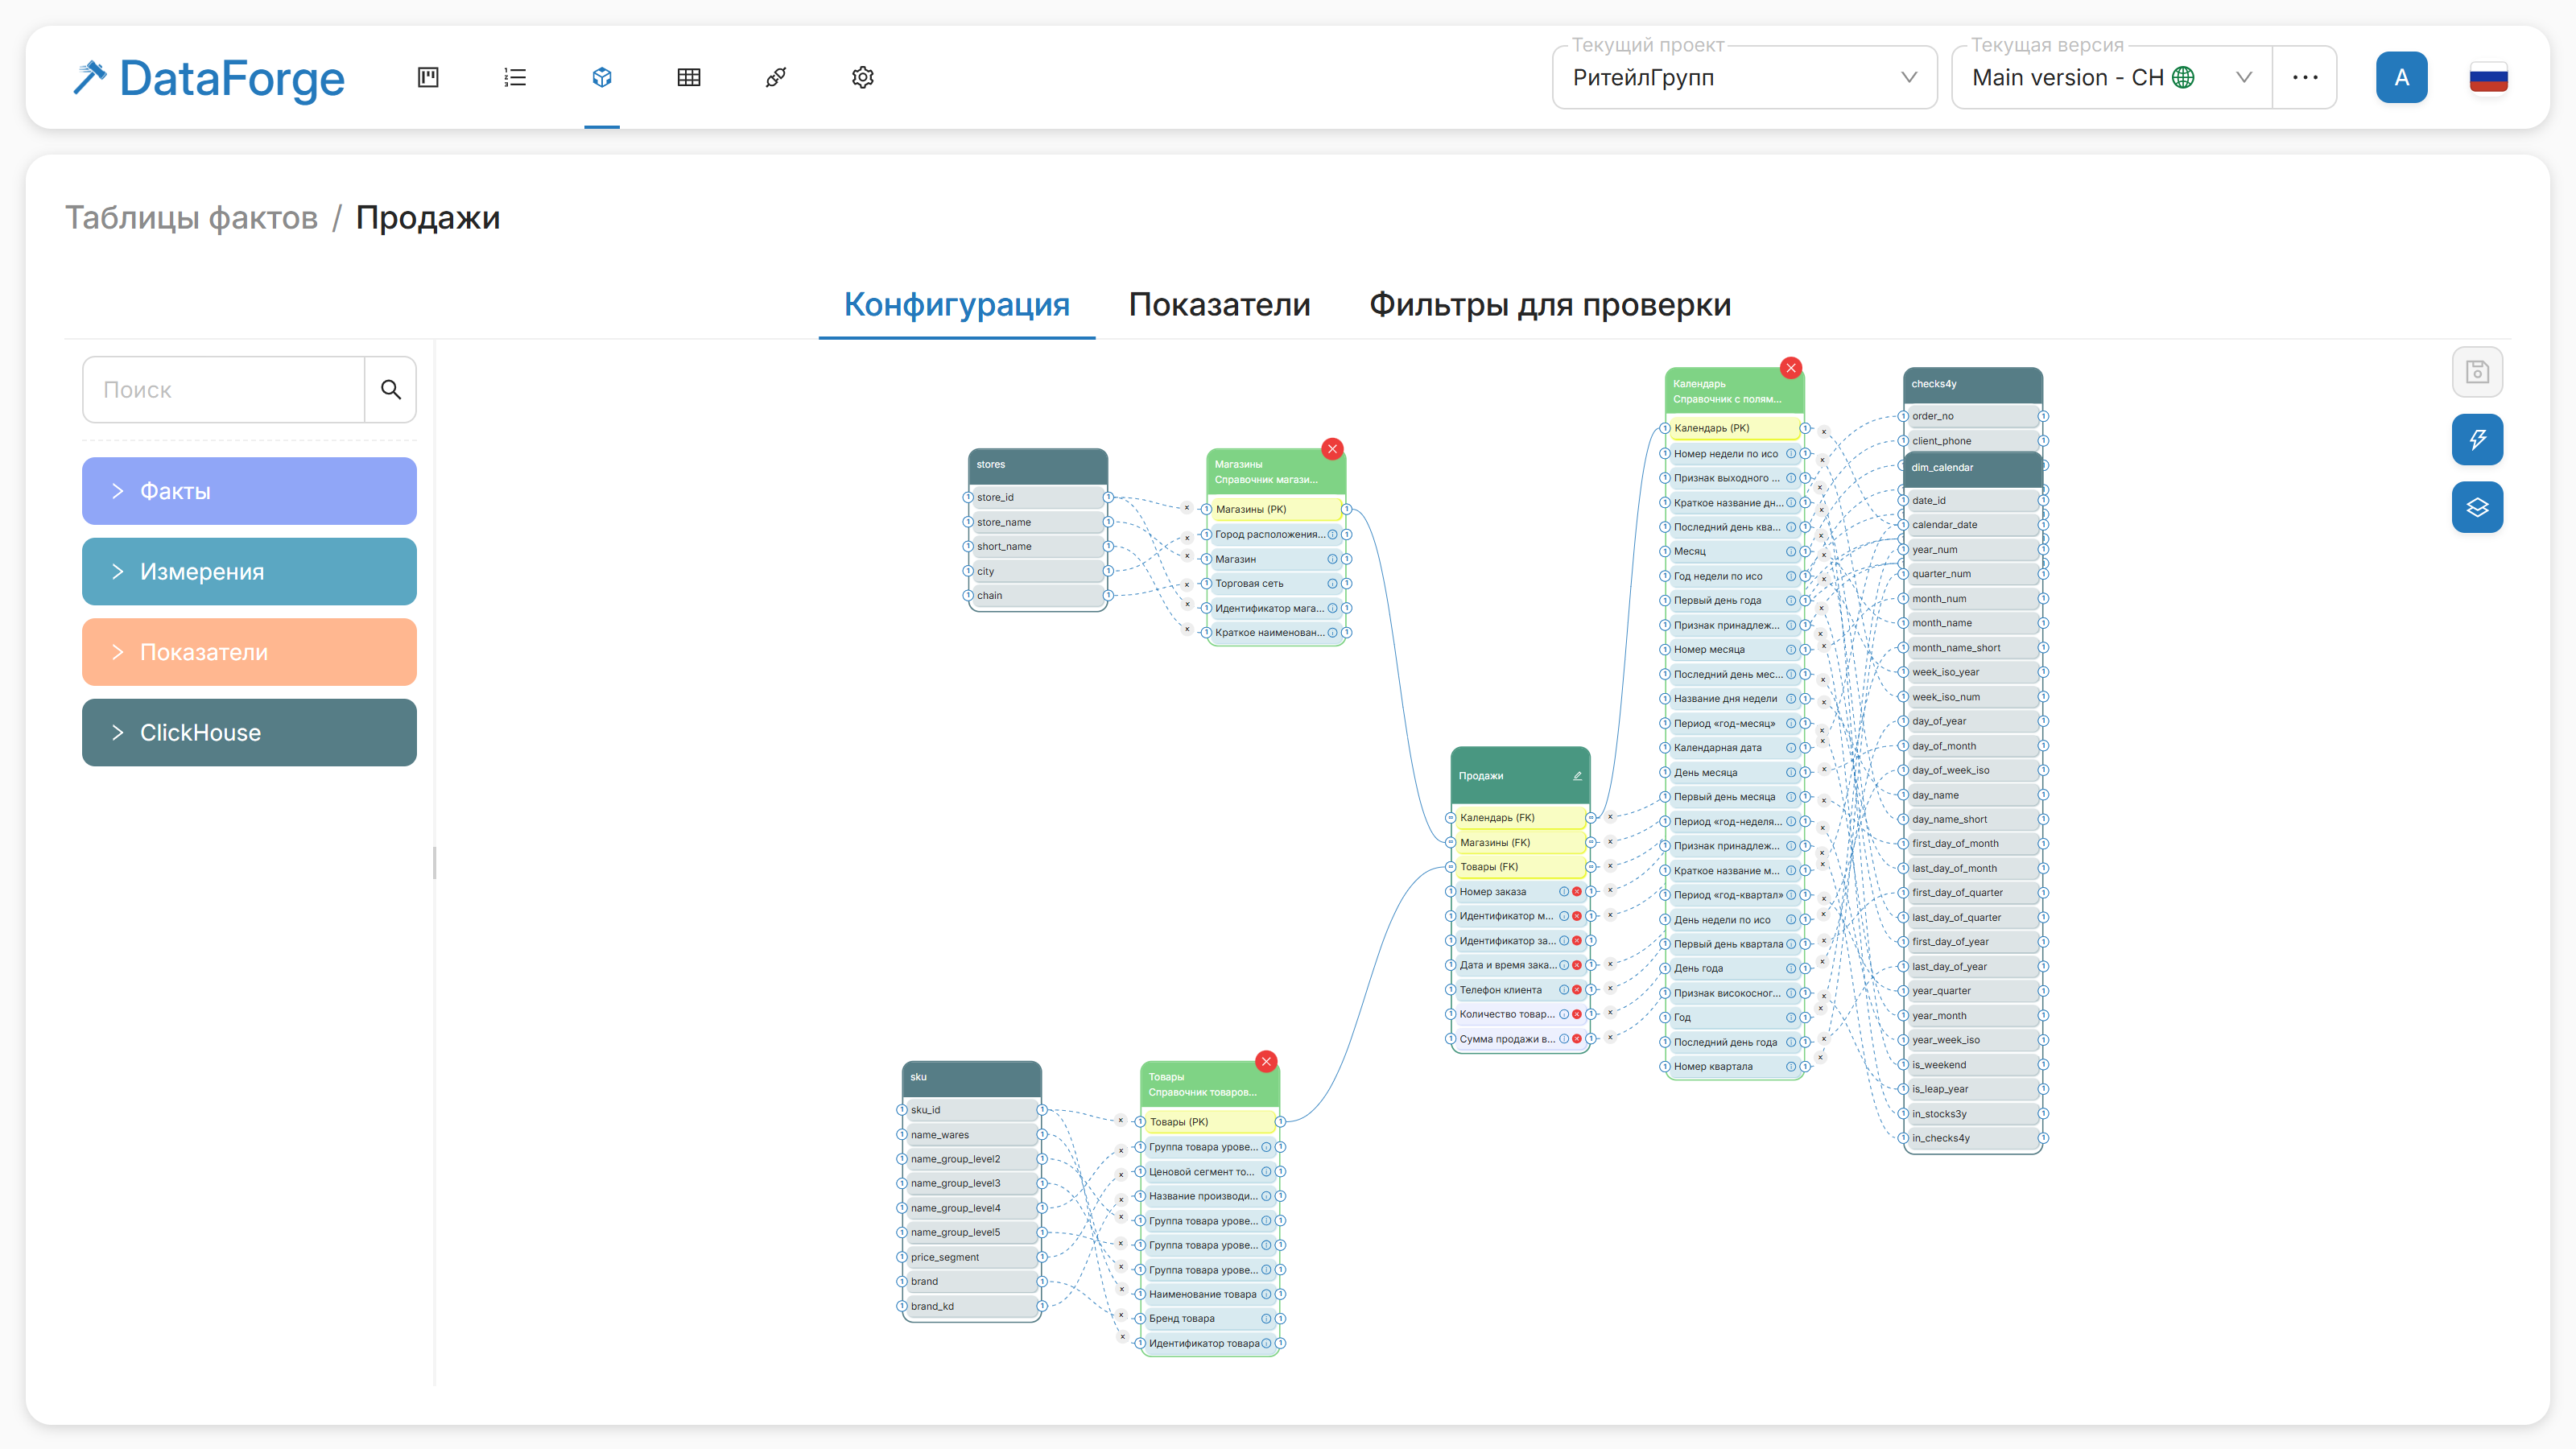
Все таблицы фактов, справочники и показатели проекта — на одной схеме со связями по ключам. Новому сотруднику достаточно одного взгляда, чтобы понять устройство хранилища.
Таблица фактов собирает показатели и измерения из реестра и связывается со справочниками. На той же схеме видно, из каких таблиц и колонок хранилища берётся каждый элемент.
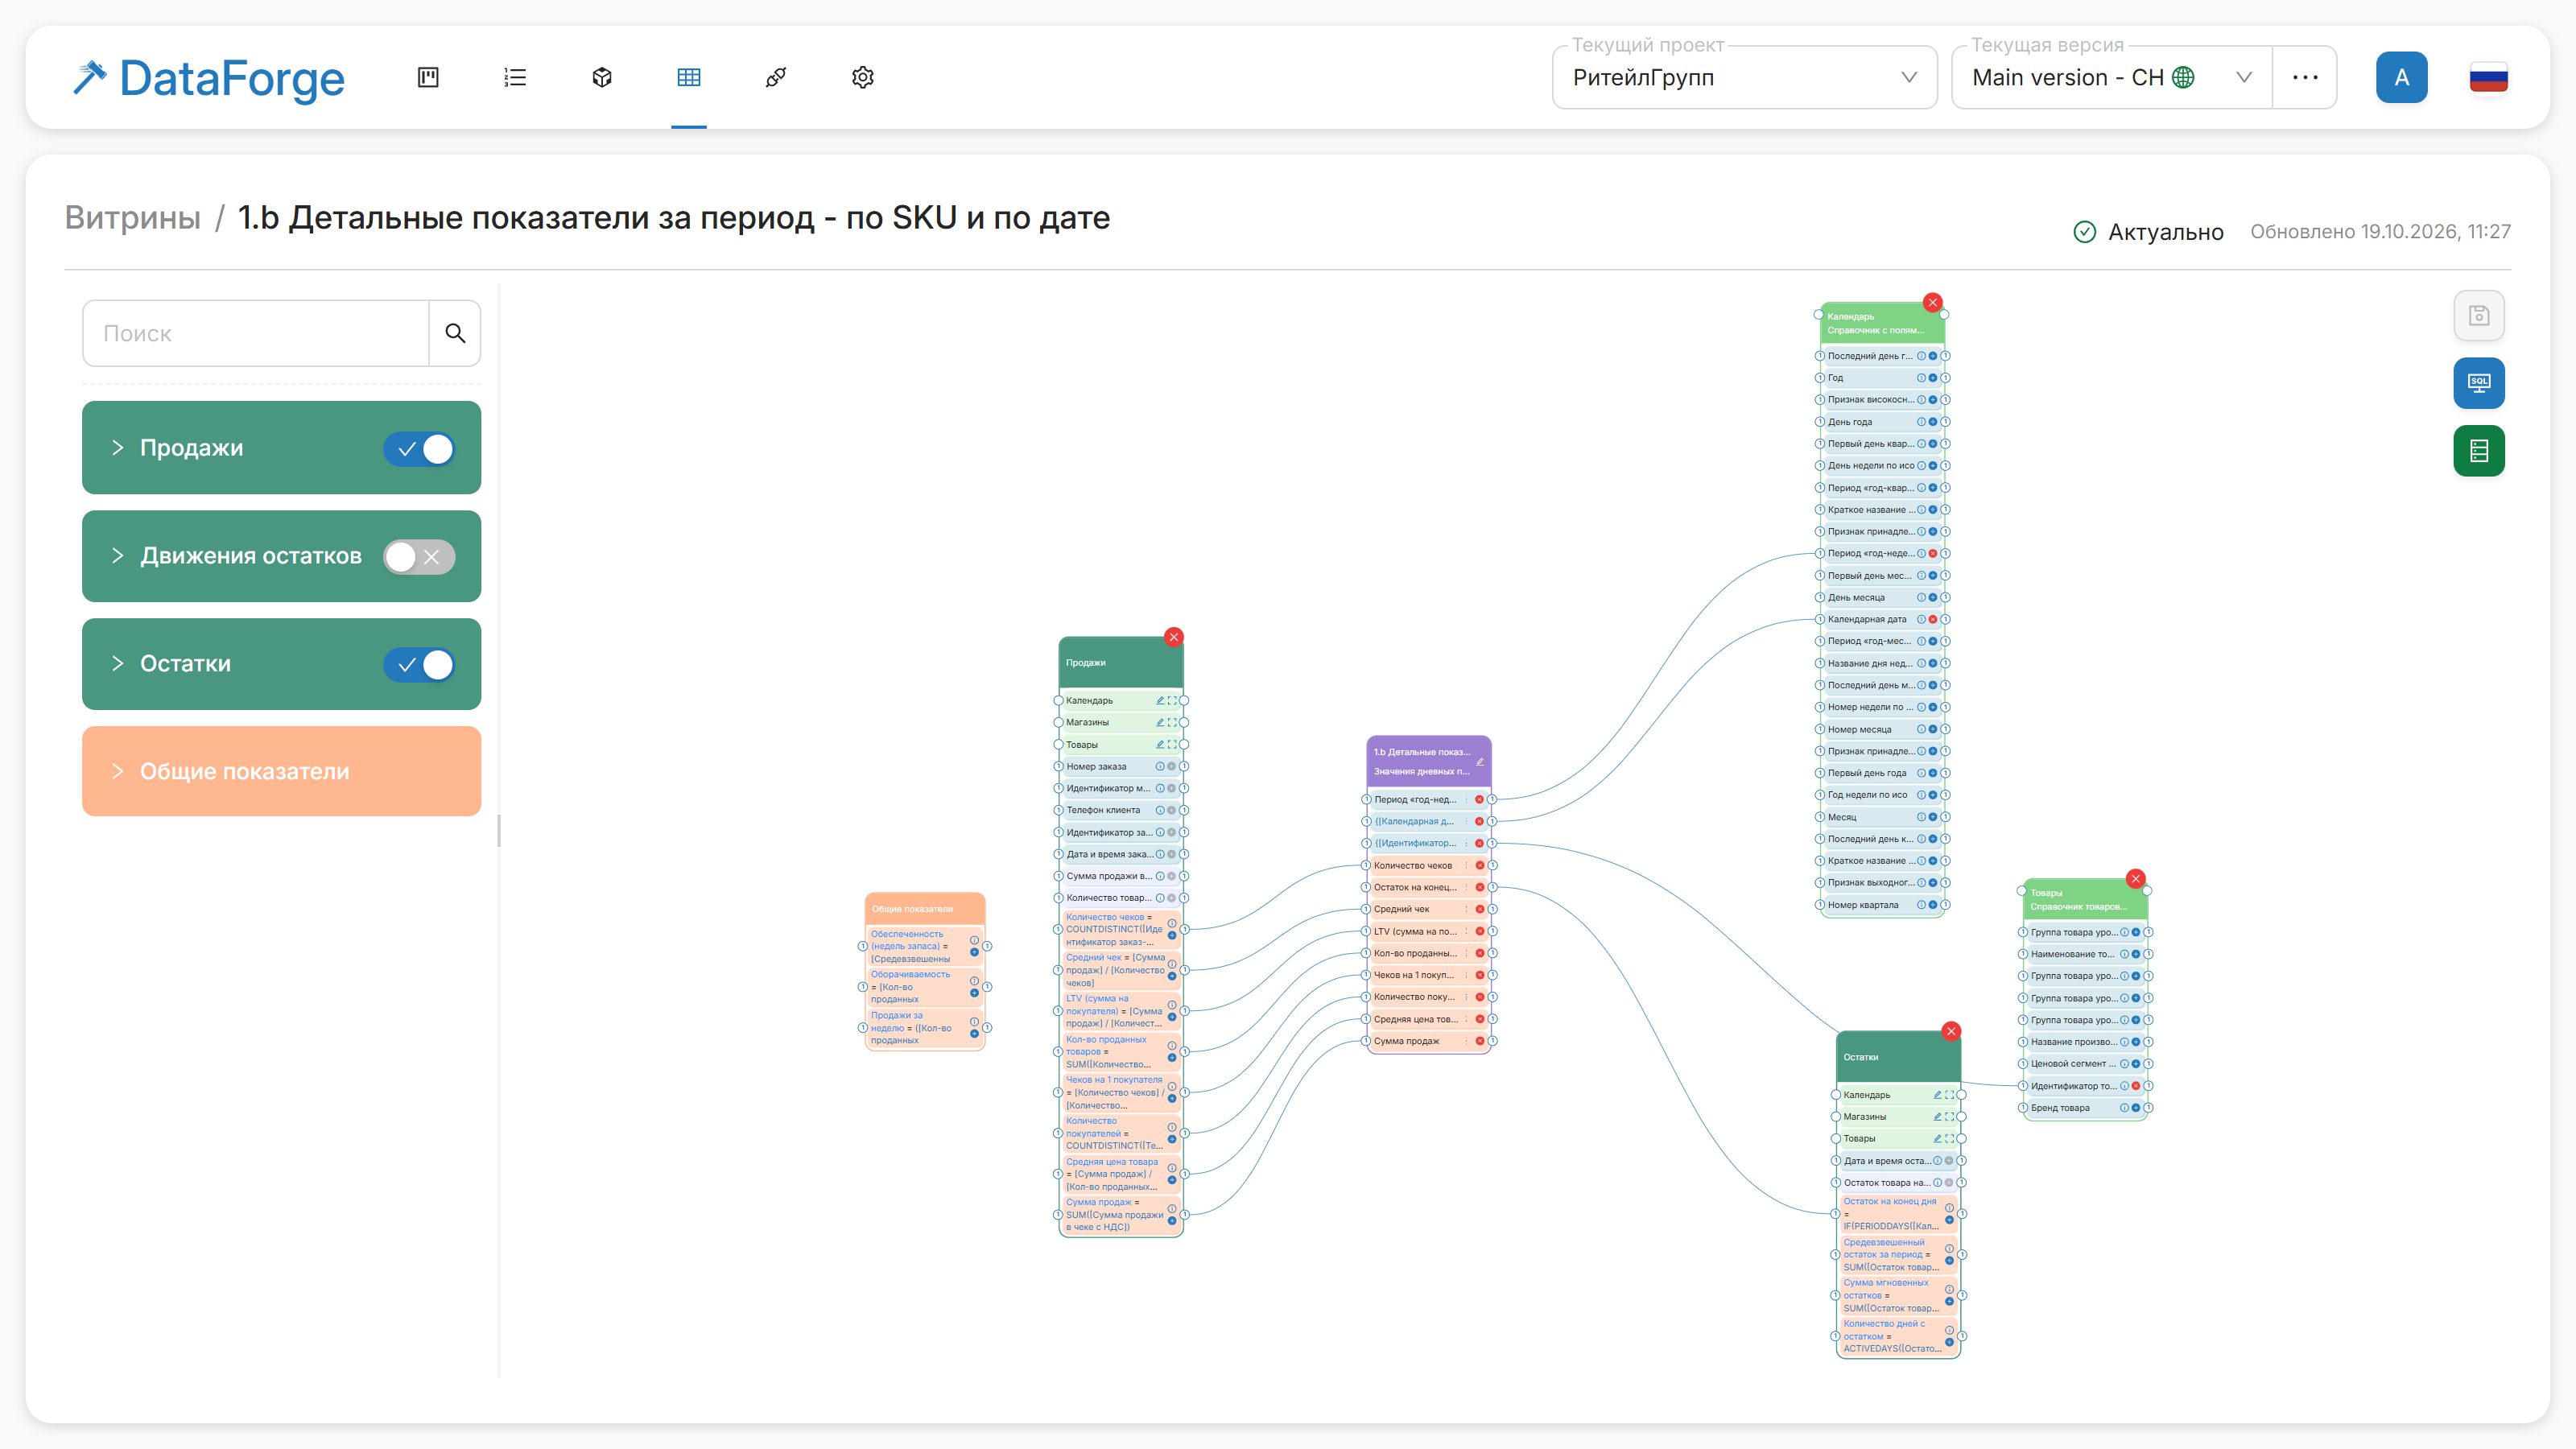
Аналитик собирает витрину на холсте из показателей и измерений реестра, а нужные таблицы фактов и связи DataForge находит сам. Справочник добавляется на холст одной кнопкой «Развернуть».
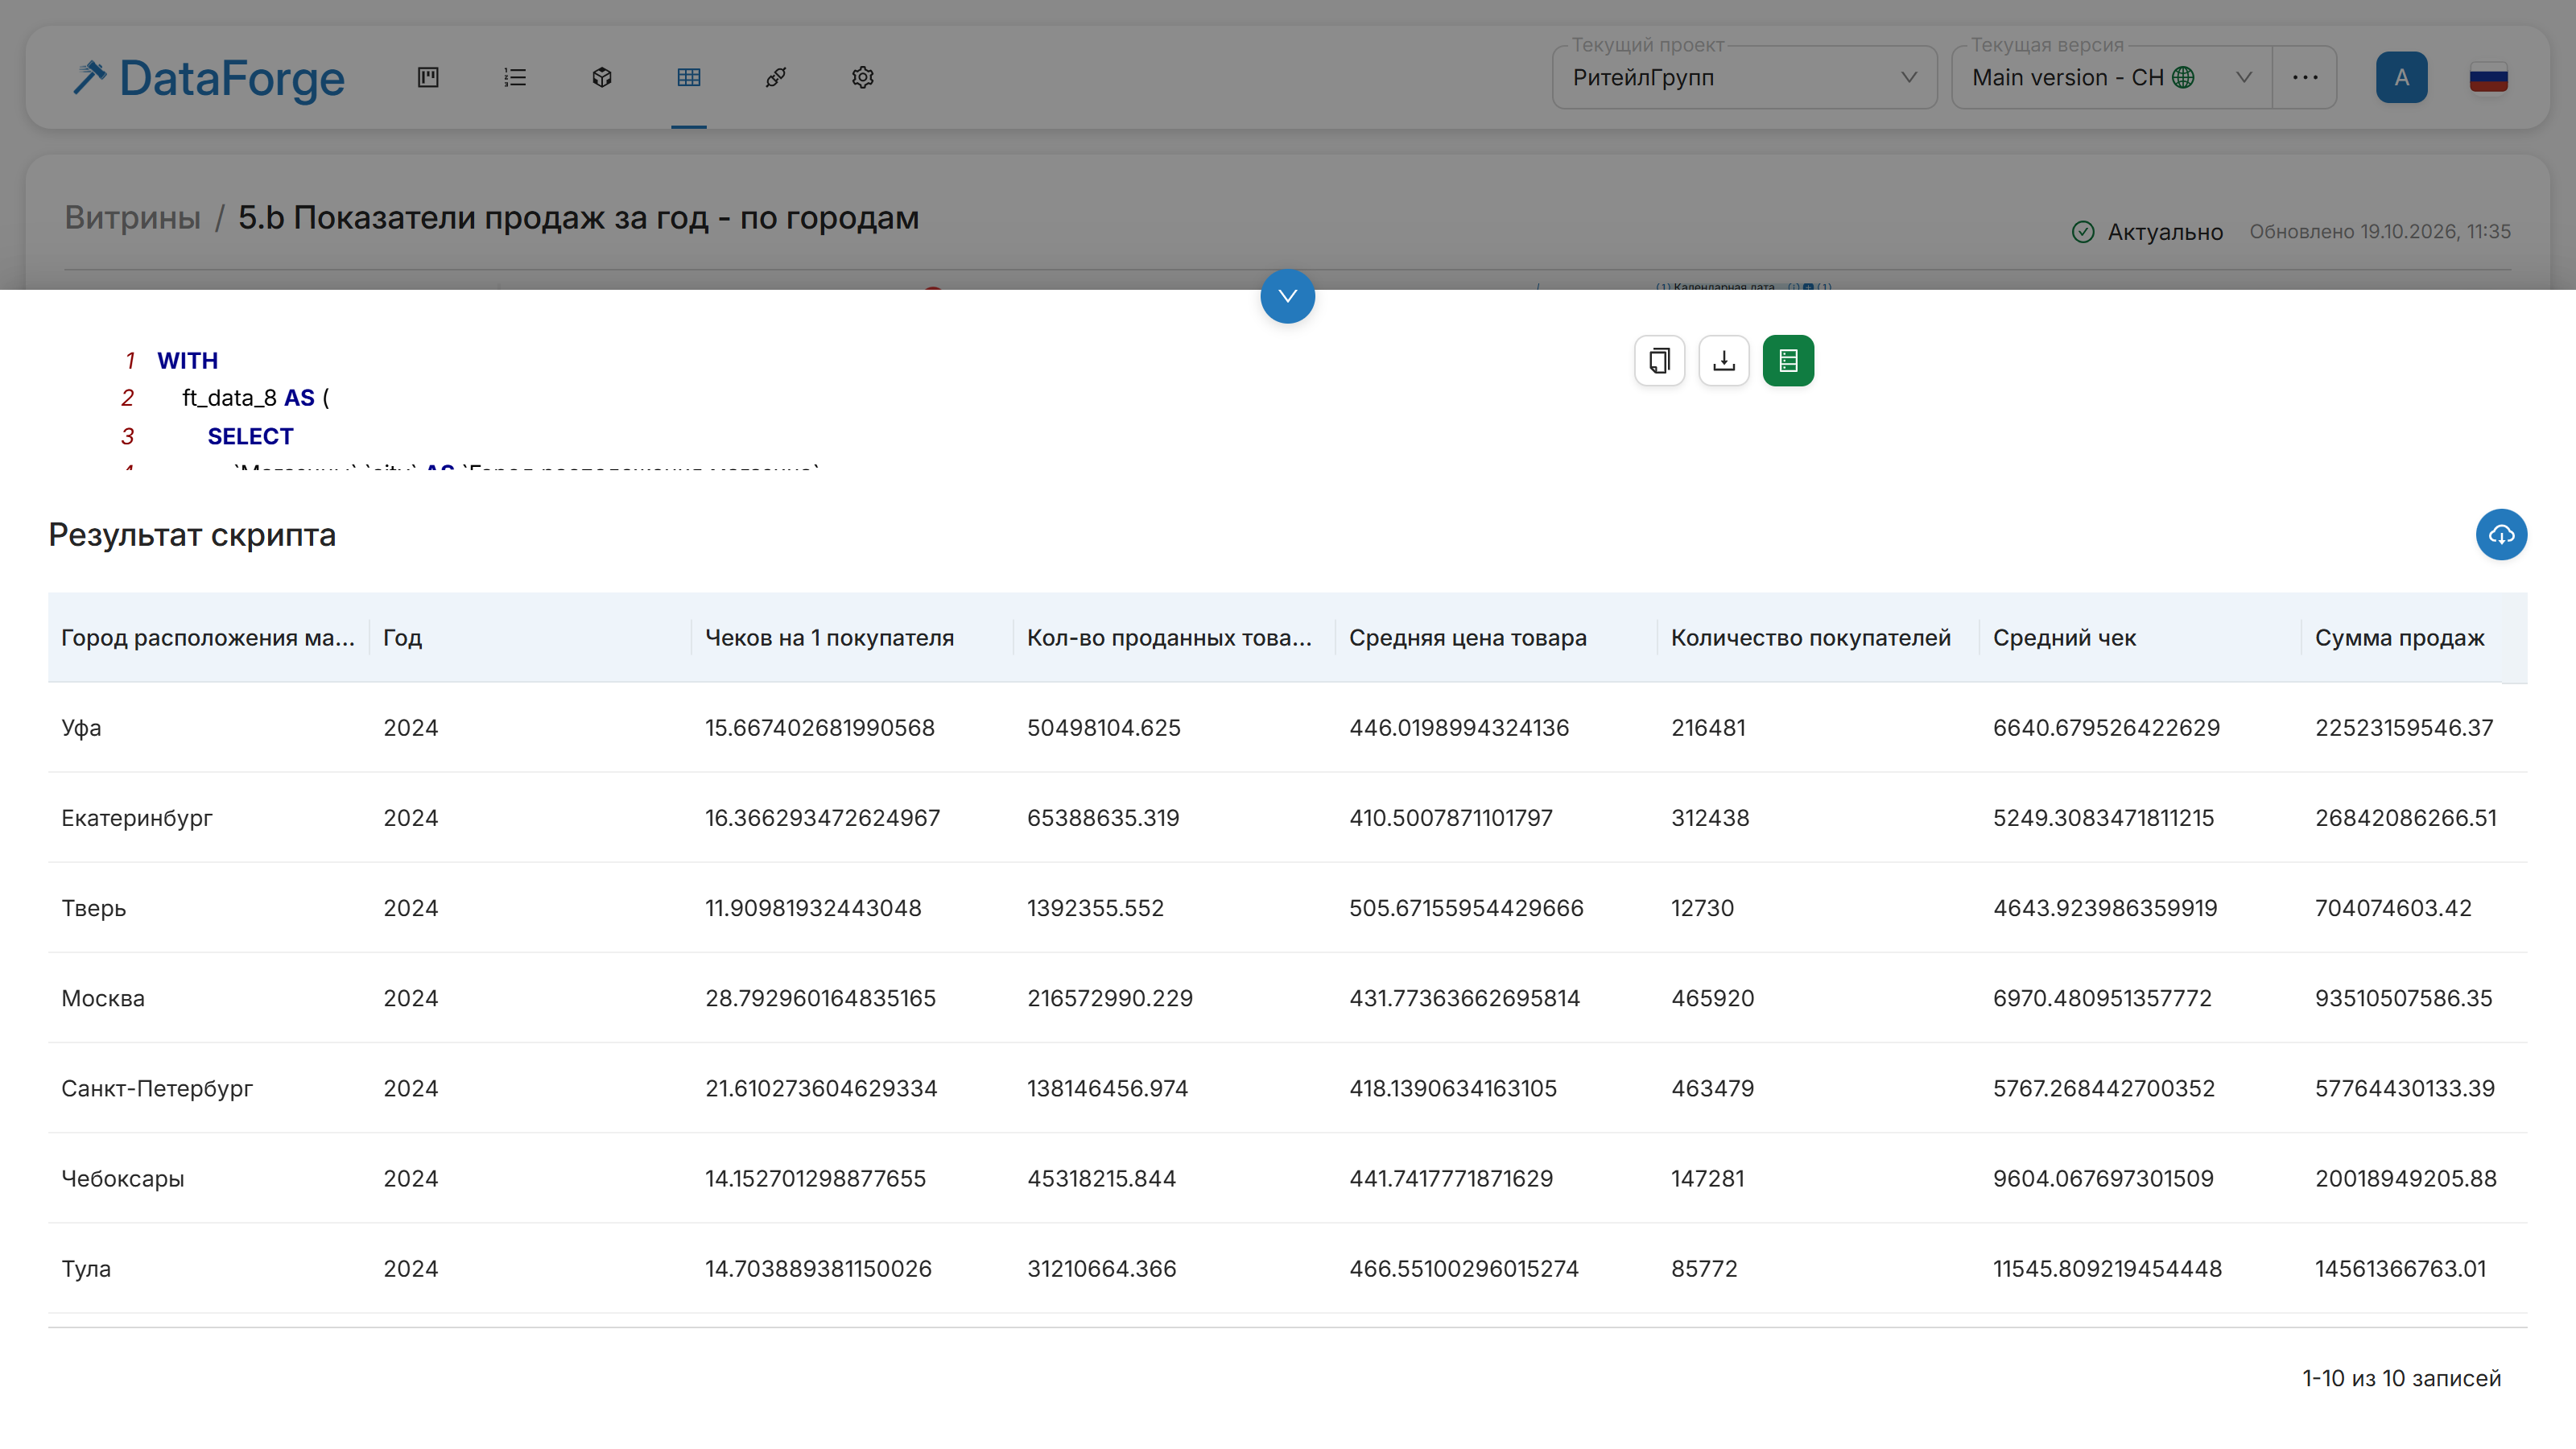
DataForge генерирует SQL-запрос витрины для нужной СУБД и сразу выполняет его на данных хранилища — результат виден рядом с запросом. Ошибки находятся до того, как витрину увидят пользователи.
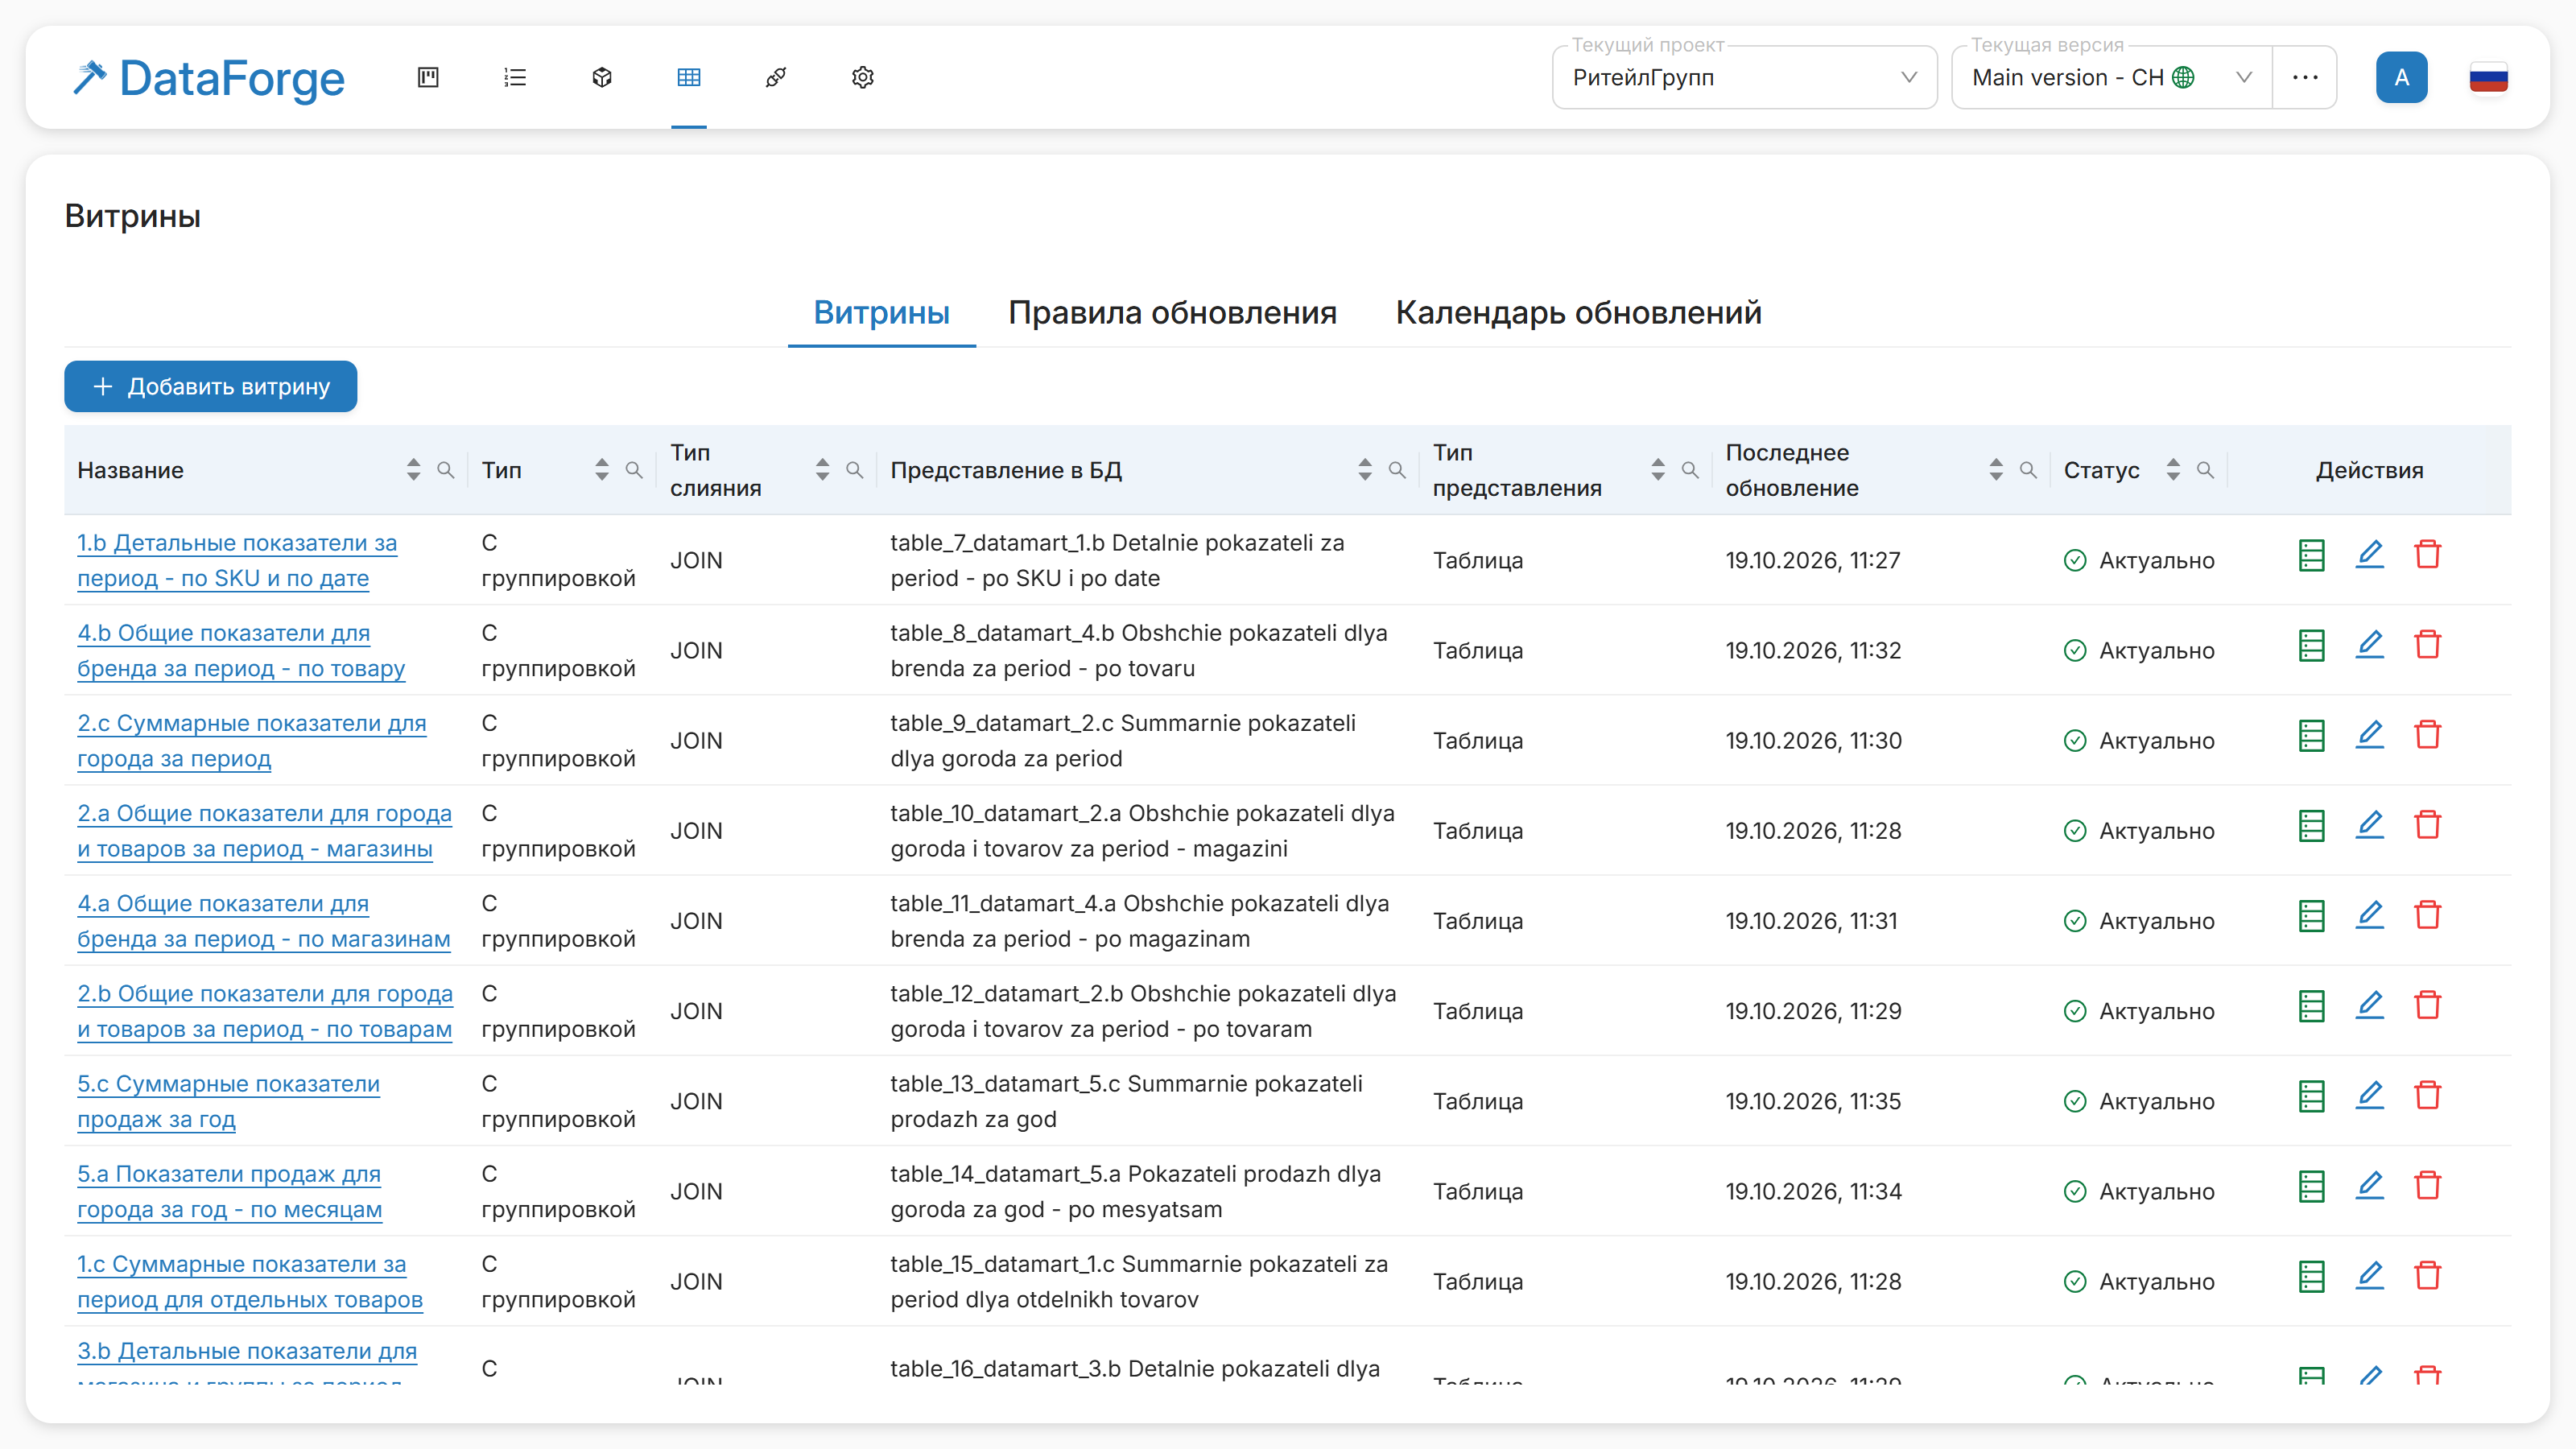
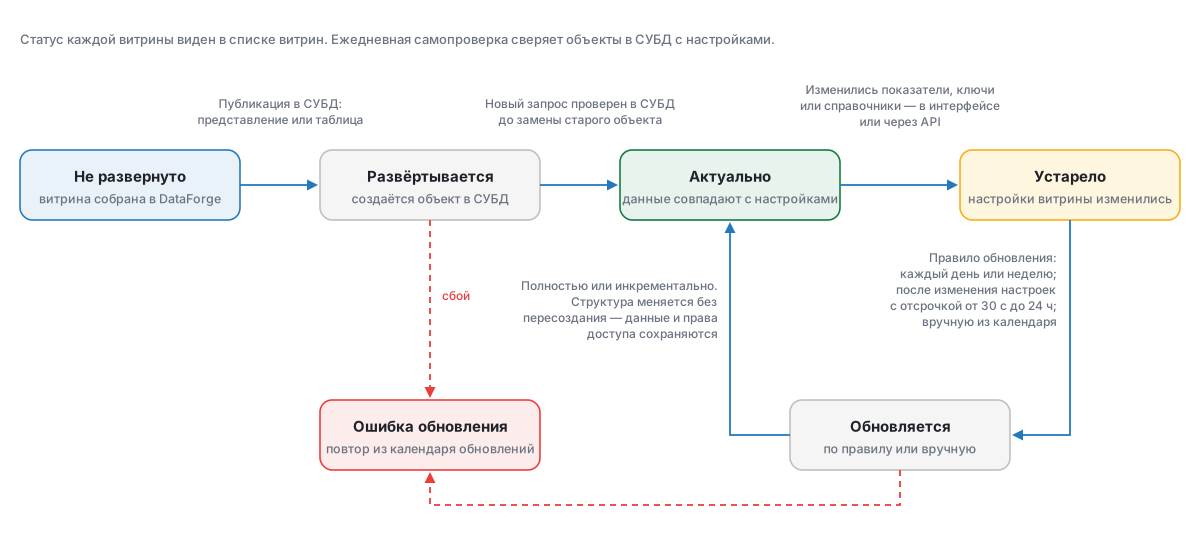
После публикации DataForge следит за объектом в СУБД. Если поменялись показатели, справочники или настройки витрины — вручную или через API, — объект помечается «Устарело» и обновляется по правилу: по расписанию или сразу после изменения.
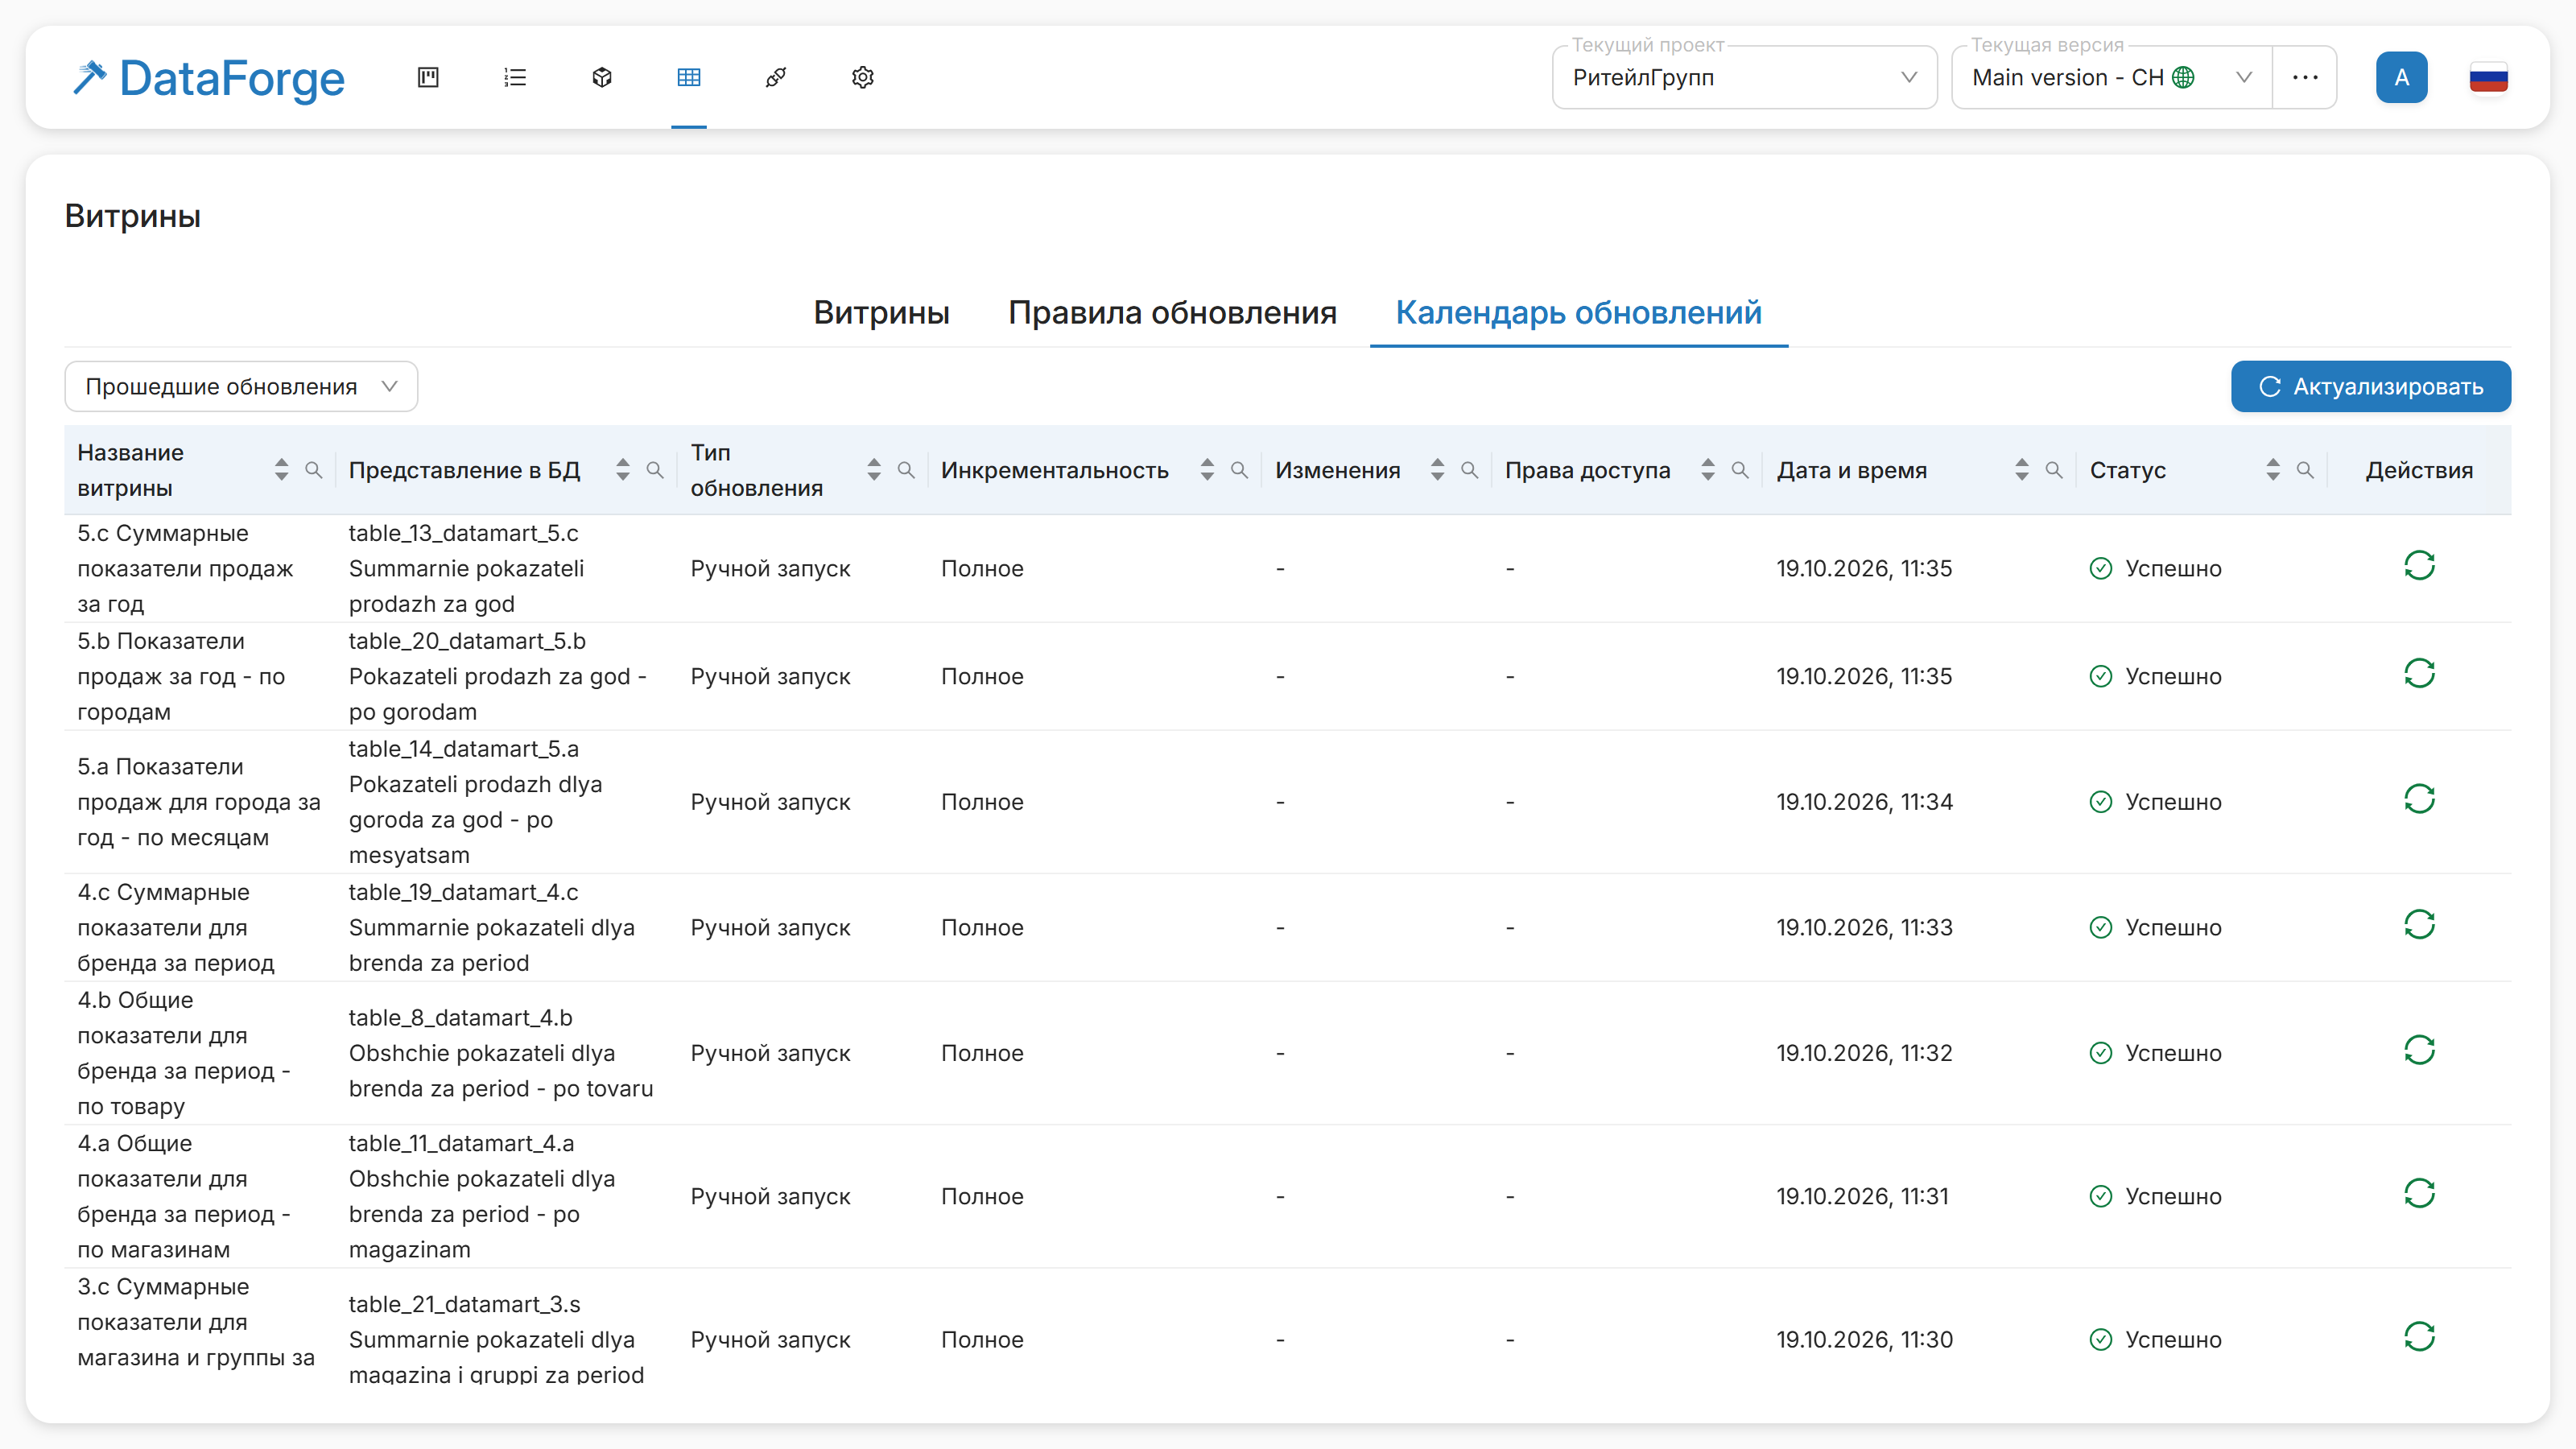
Вместо полной перезаписи DataForge записывает в витрину только разницу — на больших объёмах это заметно сокращает время обновления. Все запуски видны в календаре: будущие можно отменить, прошедшие — повторить.
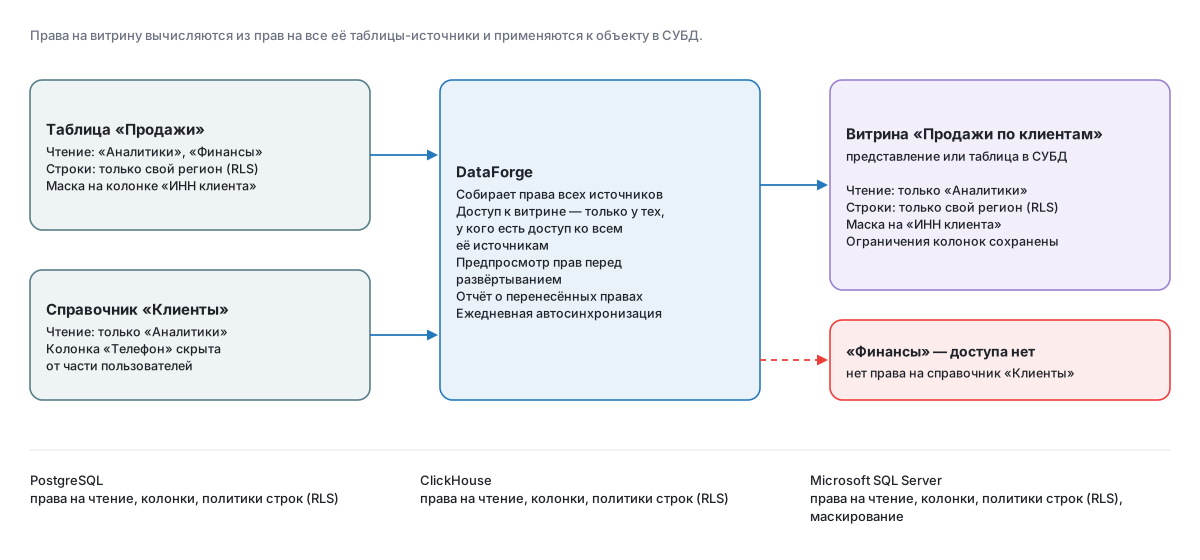
DataForge собирает права всех таблиц, из которых строится витрина, и переносит их на объект в СУБД: права на чтение, ограничения по колонкам, политики доступа к строкам и маскирование. Доступ получает только тот, у кого есть доступ ко всем источникам.
Любое изменение можно оценить заранее, а проект — встроить в процессы компании.
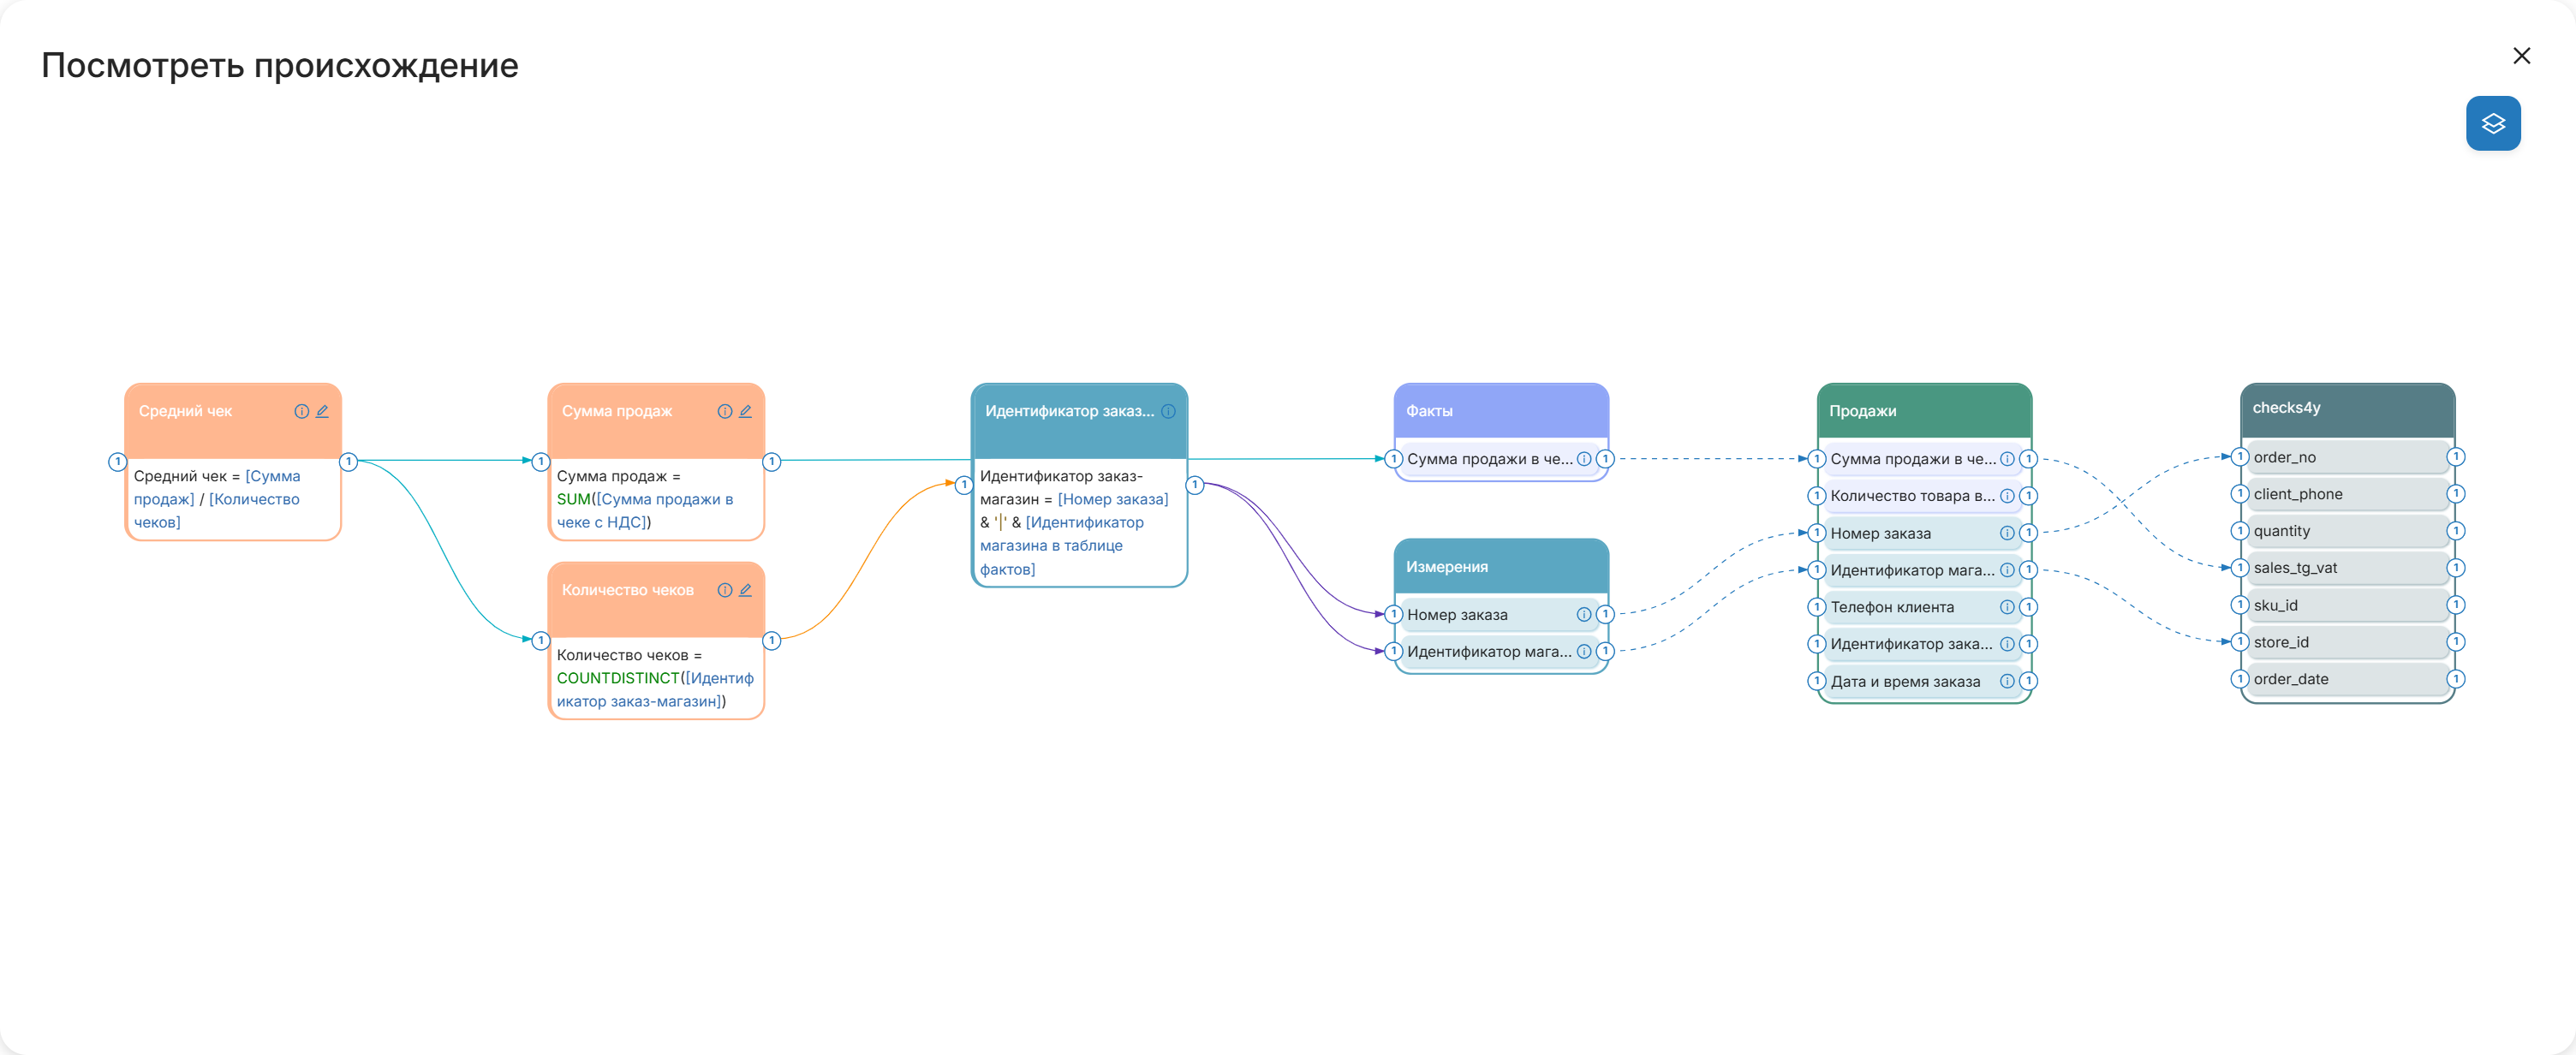
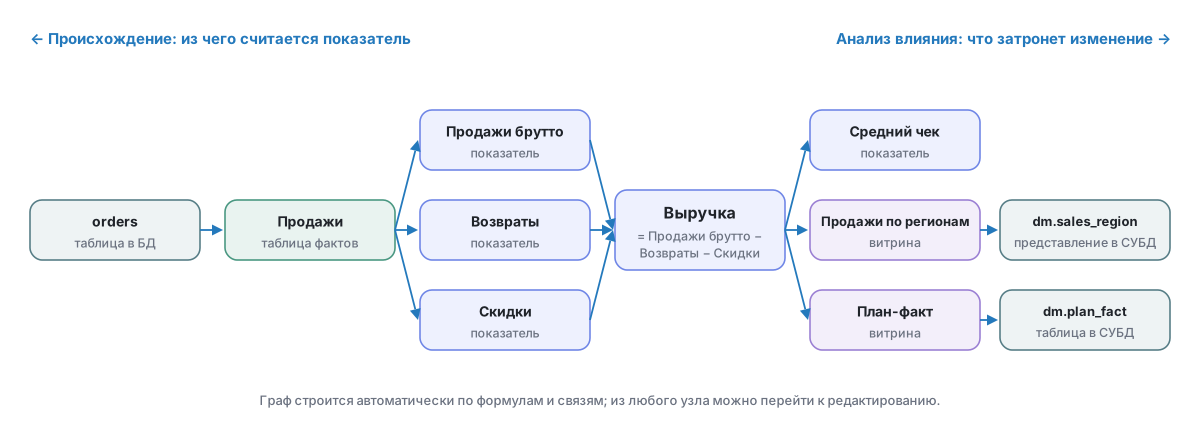
Происхождение показывает, из чего собран показатель, а анализ влияния — всё, что от него зависит: другие показатели, таблицы фактов, витрины и их объекты в СУБД. Прежде чем поменять формулу, аналитик видит, какие отчёты это заденет.
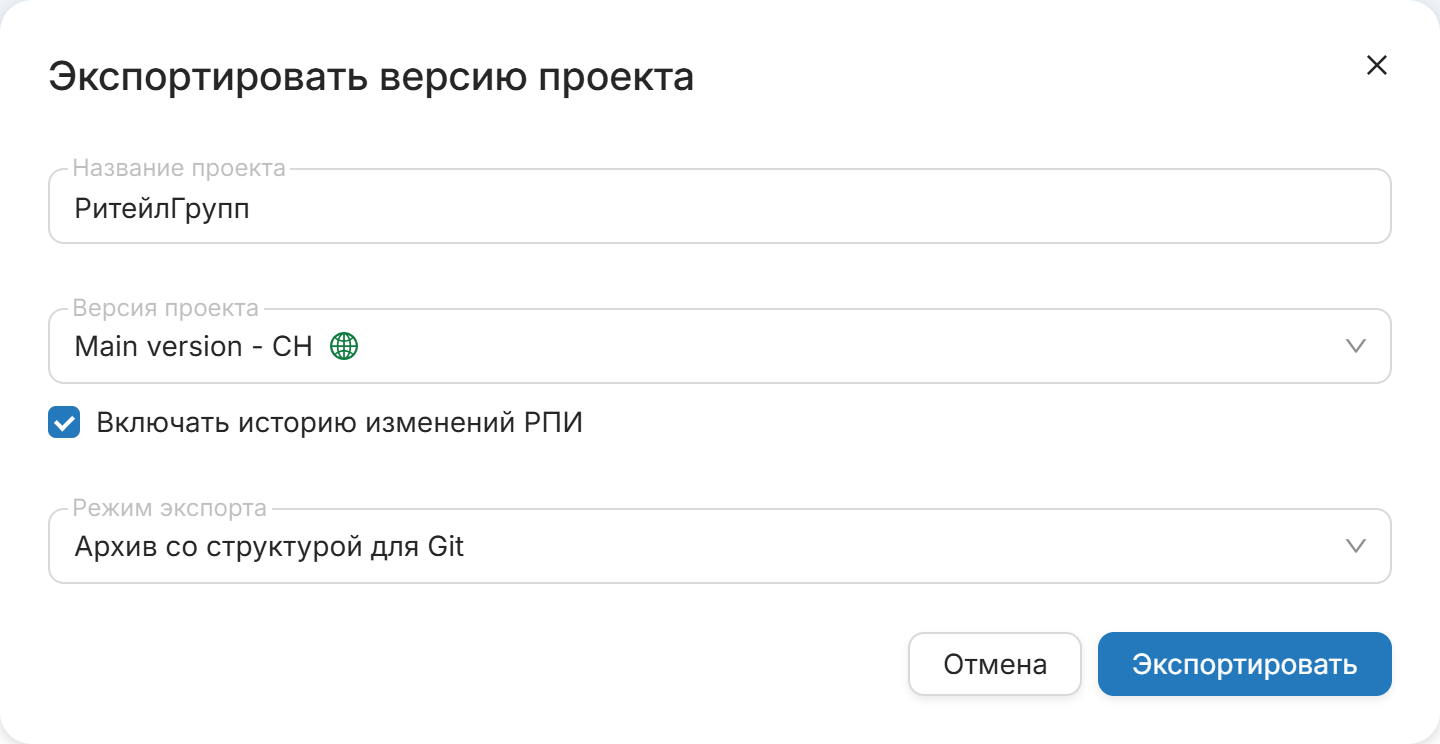
Версию проекта — РПИ, таблицы фактов, витрины, модель данных — можно выгрузить прямо в ветку Git и загрузить обратно. Повторная выгрузка без изменений даёт те же файлы, поэтому в Git видны только настоящие изменения.
Внешние системы не только читают реестр, но и меняют его: создают показатели, справочники и таблицы фактов, выгружают и загружают версии. Поддержку реестра можно автоматизировать из других систем, конвейеров CI/CD и ИИ-агентов.
Корпоративные учётные записи, личные права в СУБД и полный журнал действий.
Сотрудники входят в DataForge с теми же учётными записями, что и в остальные системы компании. Роли назначаются по группам каталога, а имя и группы обновляются при каждом входе.
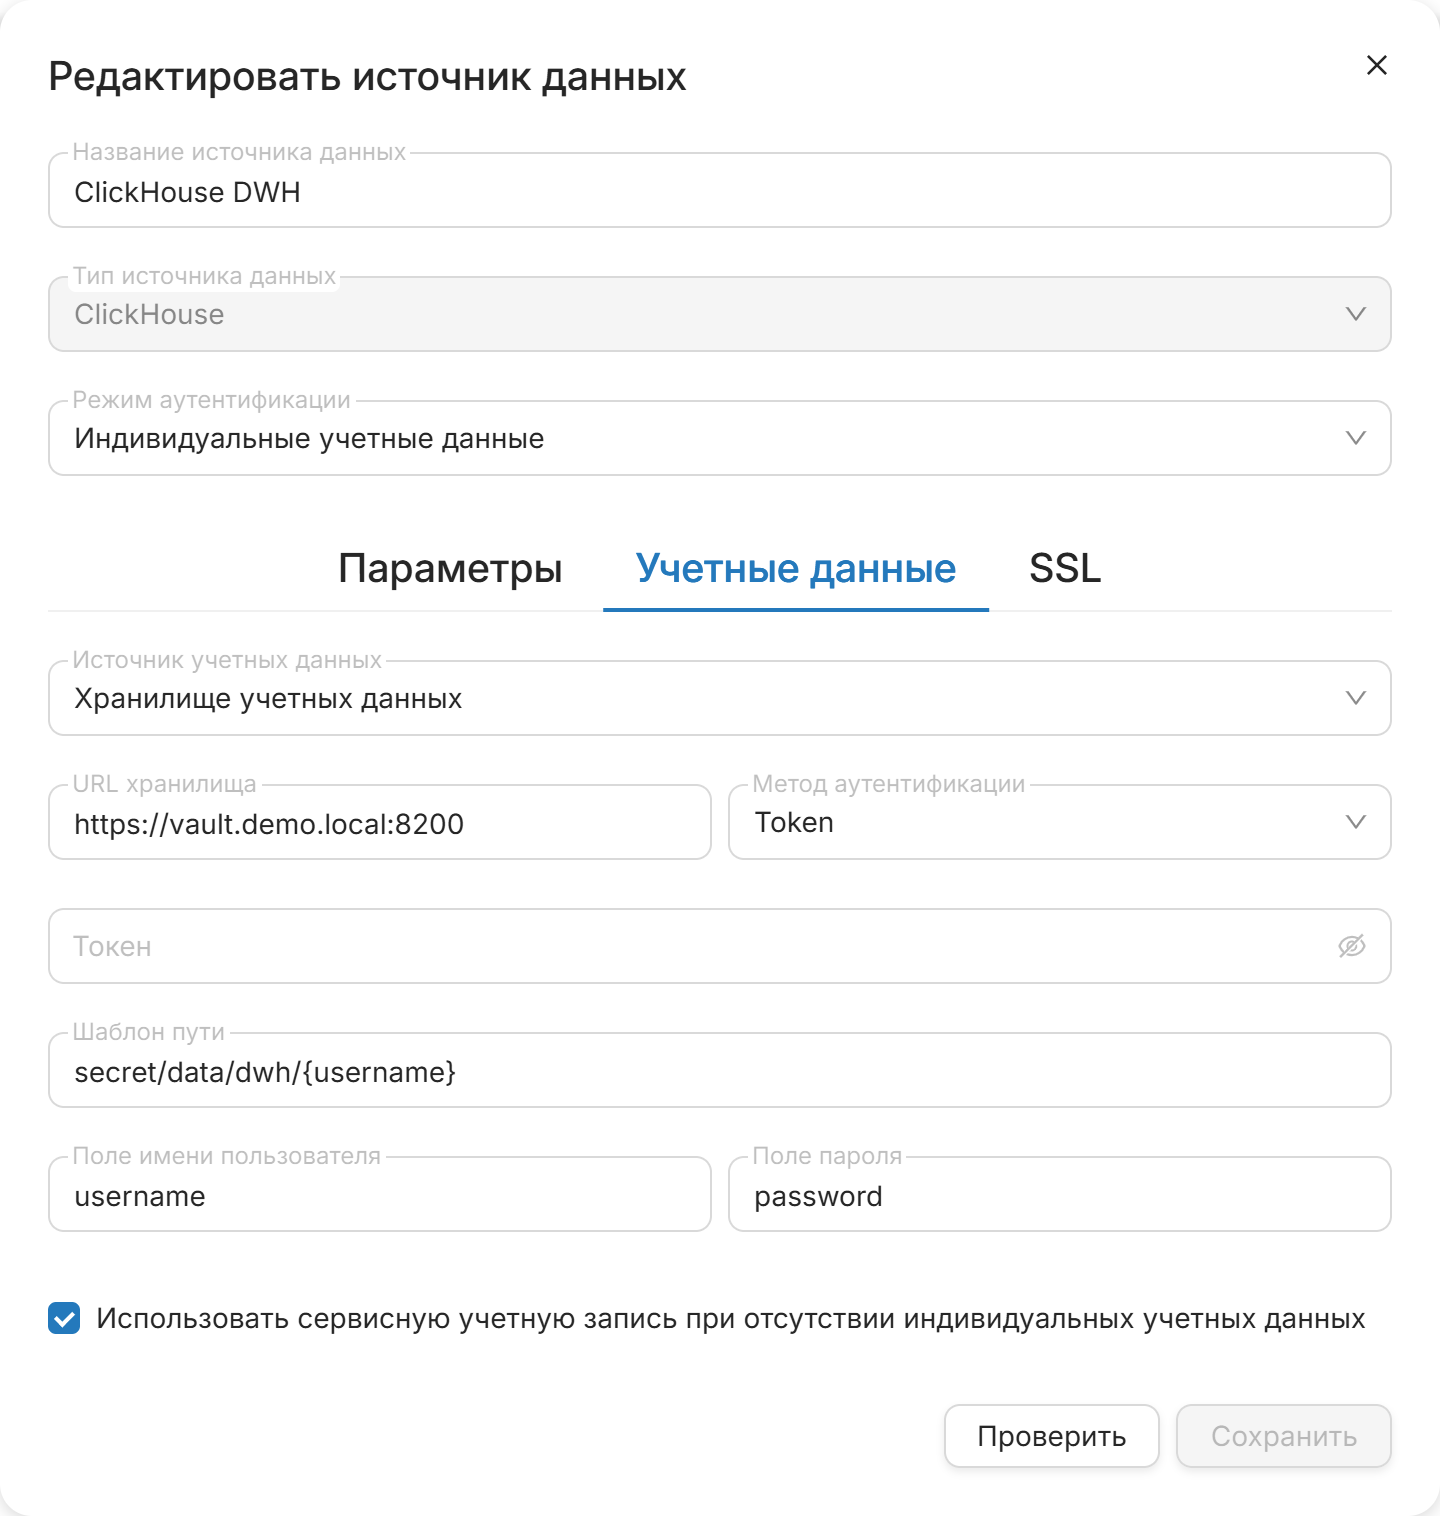
Администратор описывает подключение к хранилищу один раз — и оно используется во всех проектах. Когда пользователь смотрит данные показателя или витрины, запрос выполняется под его собственной учётной записью: СУБД применяет его права.
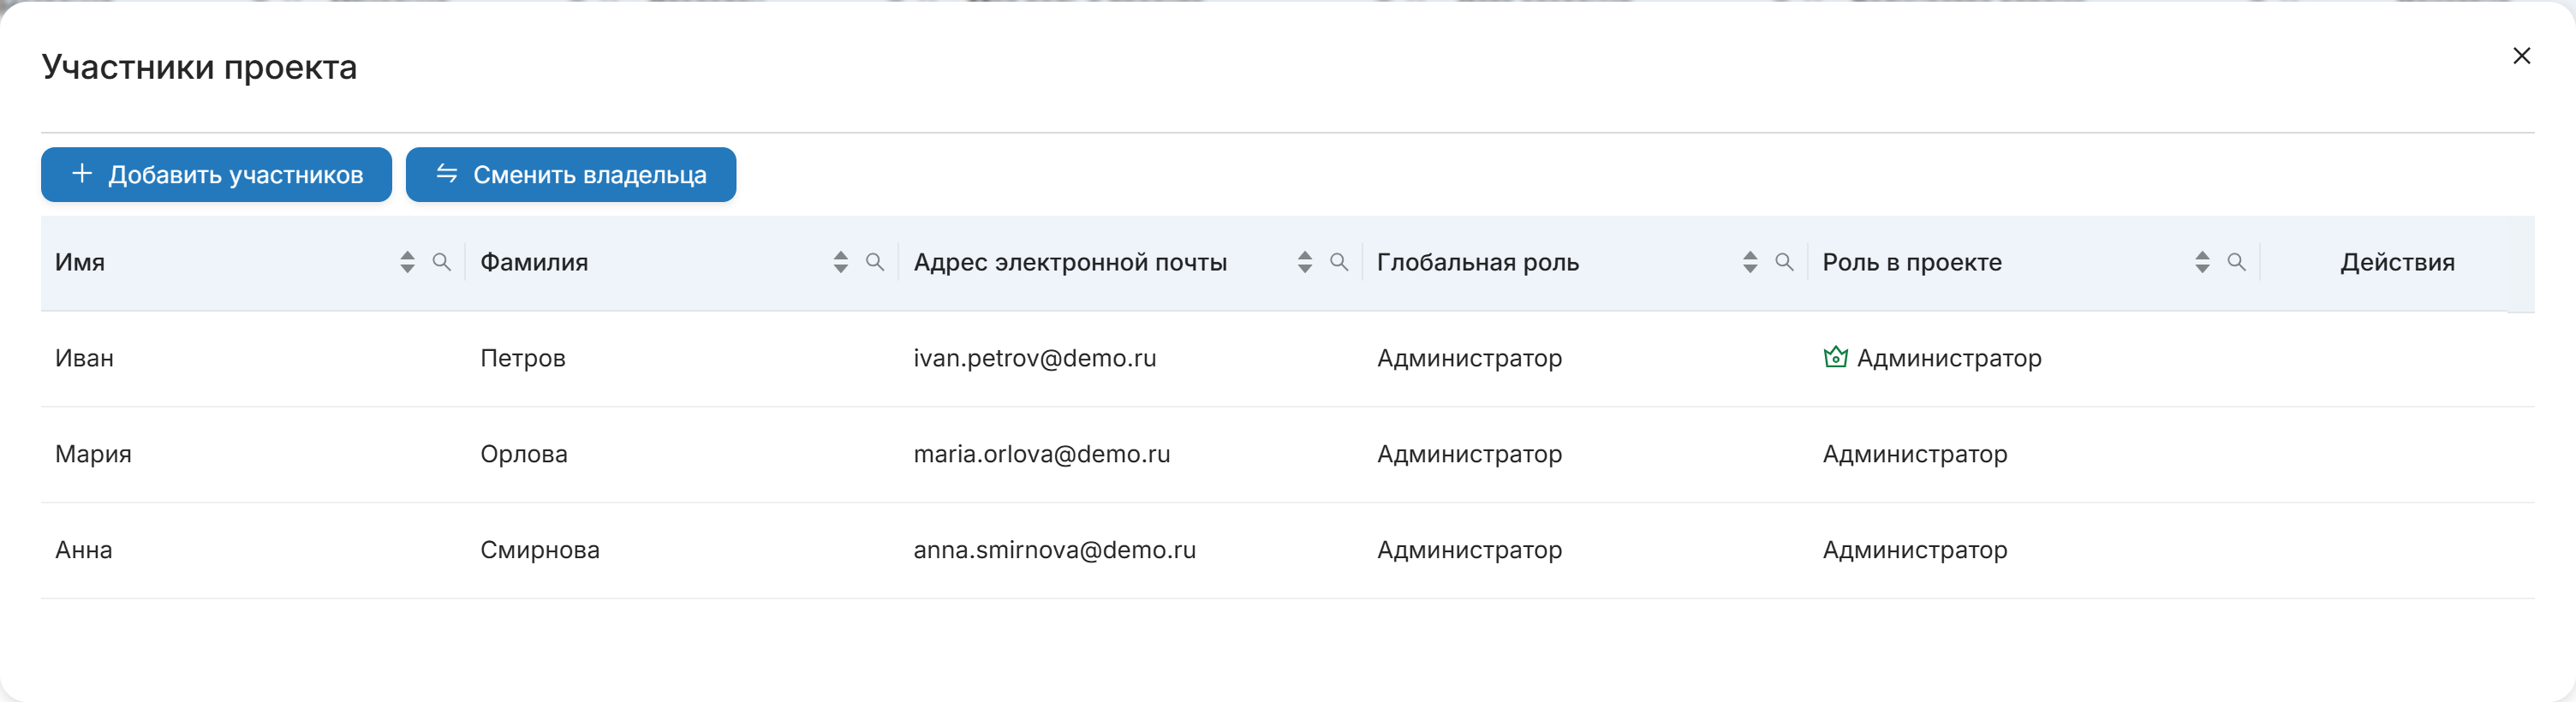
Каждый проект открывается конкретным людям с нужным уровнем доступа — остальные его не видят. У проекта есть владелец, который сам управляет участниками.
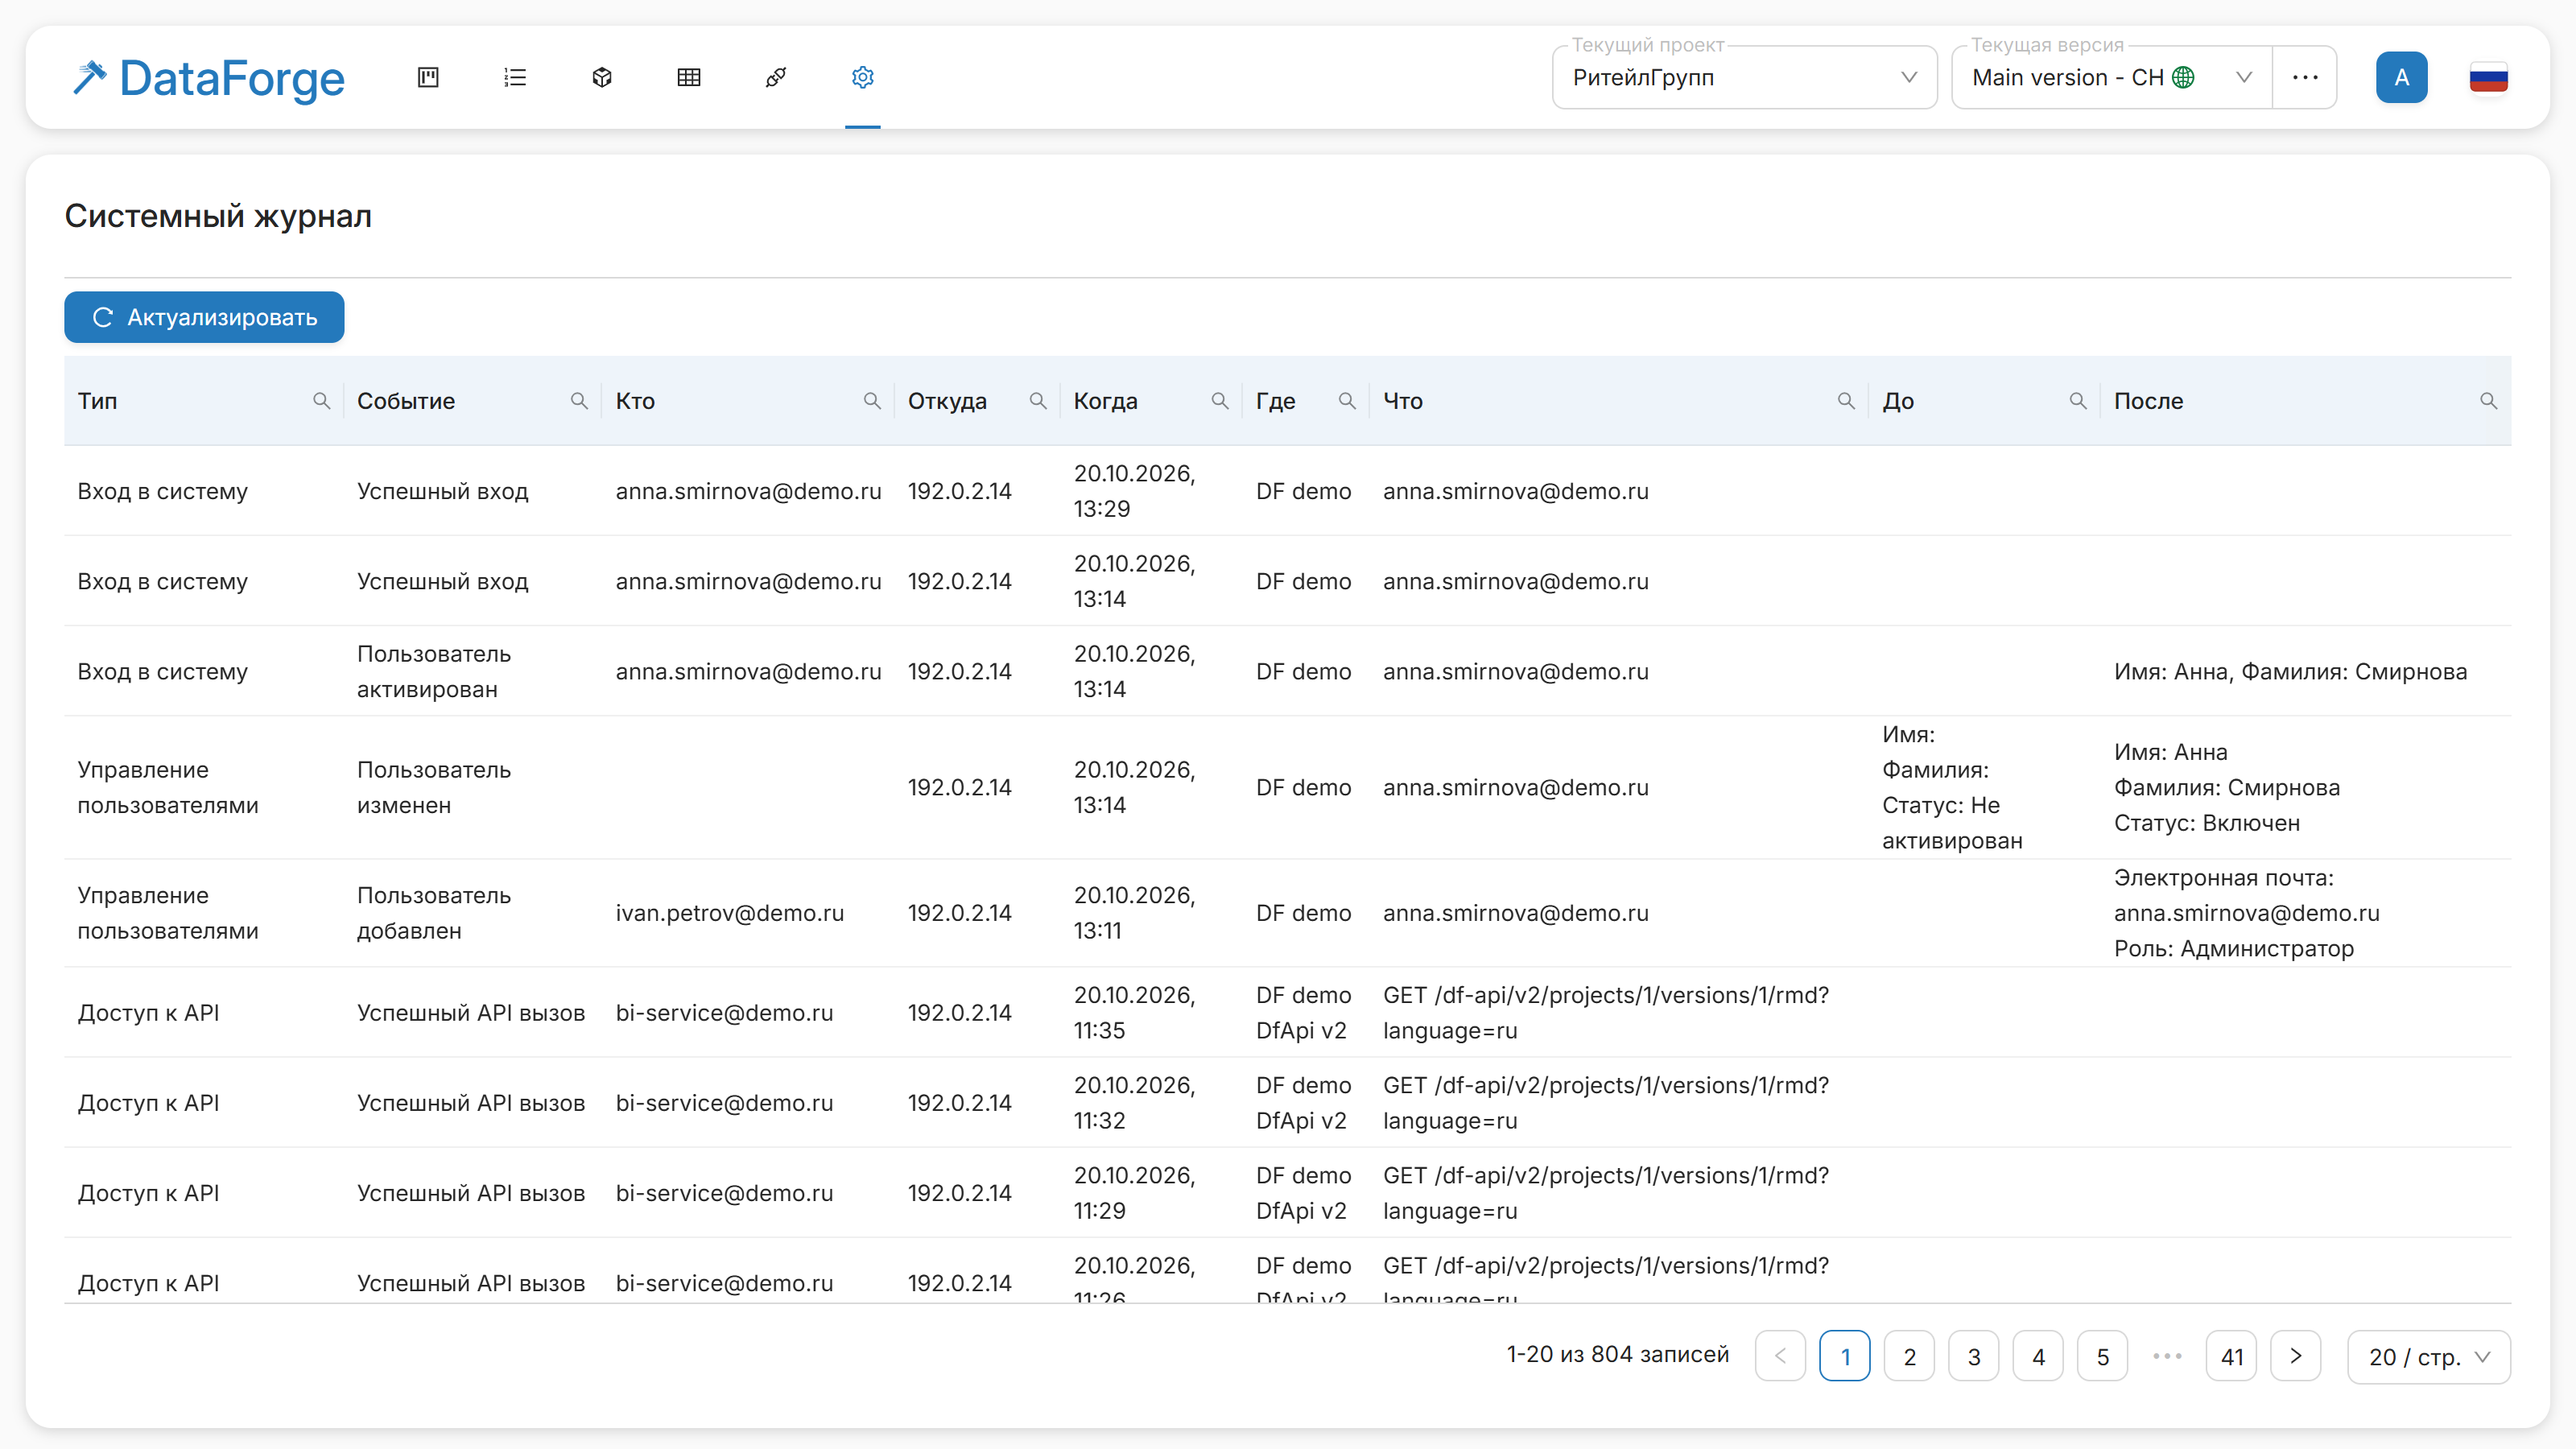
В журнал попадают действия пользователей и вызовы API с состоянием «до» и «после»: входы, доступ к проектам, источники данных, экспорт, импорт, Git. Журнал компании видят только её администраторы.
Руководства, инструкции и материалы по сопровождению платформы.
20.08.2026
За последние два года вокруг корпоративных данных появилось очень много новых терминов: онтология, таксономия, Knowledge Graph, semantic layer, context layer, context graph, GraphRAG. Часть этих понятий существовала задолго до нынешней волны генеративного ИИ, но именно появление аналитических агентов резко повысило к ним интерес. Причина довольно простая: оказалось, что одной большой языковой модели и прямого доступа к базе данных недостаточно, чтобы надежно отвечать на бизнес-вопросы.21.04.2026
AI-агент для автоматического создания Реестра показателей и измерений (РПИ) Новый стандарт подготовки семантического слоя для DWH21.04.2026
ИИ-аналитик, который работает с вашими данными так же, как лучший аналитик в команде - только быстрее20.02.2026
Почти во всех компаниях проблема аналитики звучит одинаково: «Почему один и тот же показатель в отчётах разный?» Обычно начинают проверять ETL, BI-инструмент, качество данных, права доступа. Но в большинстве случаев проблема вообще не в технологиях. Проблема — в архитектуре. Точнее — в том, в каком слое реализованы бизнес-правила.12.02.2026
Эта статья — не про конкретный инструмент и не про «правильный стек». Она про то, как в open-source экосистеме собрать семантический слой так, чтобы он действительно работал, переживал изменения и становился основой для BI, self-service и AI, а не очередным недожившим концептом.16.12.2025
В современной архитектуре корпоративных данных Gold и Platinum слои выполняют роль связующего звена между техническими уровнями хранилища и инструментами бизнес-аналитики. Это те уровни, где данные впервые начинают приобретать смысл в терминах бизнес-показателей, менеджерских отчётов, окон аналитики и предметных областей.
16.12.2025
Статья: “Зачем нужен семантический слой, если у вас уже есть BI?” Когда человек впервые сталкивается с корпоративной аналитикой, у него возникает иллюзия, что BI-система является центром управления всеми данными. BI действительно даёт возможность строить визуализации, анализировать цифры и делать срезы, однако BI — это лишь верхний слой, витрина.
16.12.2025
Сегодня запрос бизнеса — полноценная self-service платформа данных, где каждый участник процесса — аналитик, архитектор, BI-разработчик, системный аналитик — может самостоятельно работать с данными, но управляемо, безопасно и в рамках единой методологии.16.12.2025
Medallion Architecture за последние годы стала одной из наиболее распространённых методологий проектирования хранилищ данных и аналитических платформ. Её основной вклад — структурирование уровней обработки данных в независимые, чётко разграниченные зоны: Bronze, Silver, Gold и иногда Platinum. Каждый слой выполняет свою специфическую задачу.16.12.2025
За последние 20 лет архитектуры корпоративных хранилищ данных прошли несколько этапов. Современный уровень — это не просто набор таблиц, а полноценная продуктовая модель управления данными. Именно эта логика лежит в основе Data Mesh, Data Governance 2.0 и современных DWH архитектур.16.12.2025
Современные архитектуры хранилищ данных становятся всё более сложными.
Какой инструмент лучше использовать на уровне трансформаций и формирования витрин данных?
dbt и DataForge — два инструмента, которые решают задачи преобразования данных, но делают это принципиально разными методами:
16.12.2025
Data Governance — это не только процессы контроля качества, доступов и безопасности.
В зрелых компаниях управление данными выходит за рамки технических процедур и переходит в область управления смыслом.
16.12.2025
В компаниях, где строится хранилище данных, BI-система или аналитическая платформа, почти всегда возникает ситуация: разные роли смотрят на одни и те же данные по-разному.
199178, Санкт-Петербург
6-ая линия В.О., д. 63,
4 этаж
DataForge - это система для визуального моделирования и проектирования структуры хранилищ данных (DWH). Он позволяет пользователям визуально проектировать таблицы фактов методом drag-and-drop, автоматически генерировать физическую и логическую модели данных, документировать бизнес-логику и определения атрибутов, а также генерировать DDL-скрипты для создания физической модели в реляционной СУБД.
DataForge © 2025-2026 Все права защищены.