12.02.2026
Семантический слой данных в open-source архитектуре
Как вернуть смысл в аналитику, не возвращаясь в эпоху OLAP
Введение. Почему разговор о семантическом слое вообще возник
Если оглянуться на то, как сегодня устроены большинство аналитических платформ, можно заметить странный парадокс. Данных стало больше, технологий стало больше, BI-инструменты стали удобнее и мощнее, но доверие к цифрам во многих компаниях не выросло, а иногда даже снизилось. Одни и те же показатели показывают разные значения в разных отчётах. Аналитики тратят всё больше времени не на поиск инсайтов, а на объяснение, почему «эти цифры правильные, а те — нет». Бизнес всё чаще уходит в Excel, несмотря на инвестиции в современные data-платформы.
Этот парадокс почти никогда не связан с отсутствием данных или инструментов. Он связан с отсутствием зафиксированного смысла.
Исторически эту проблему решали по-разному. В эпоху OLAP-систем семантика была жёстко встроена в модель: нельзя было просто так посчитать что-то «по-другому». В эпоху SQL-хранилищ и self-service BI гибкость победила дисциплину, и смысл начал расползаться. Сегодня, с приходом API-ориентированных архитектур, ML и LLM, проблема смысла стала ещё острее: если люди могут спорить о цифрах, то машины тем более не понимают, что именно имели в виду.
Именно в этом контексте снова возник термин «семантический слой». Но если вендорские презентации часто подают его как ещё один продукт или модуль, на практике семантический слой — это архитектурная дисциплина, а не коробка.
Эта статья — не про конкретный инструмент и не про «правильный стек». Она про то, как в open-source экосистеме собрать семантический слой так, чтобы он действительно работал, переживал изменения и становился основой для BI, self-service и AI, а не очередным недожившим концептом.
Во многих компаниях разговор о семантическом слое начинается с искреннего непонимания. Есть хранилище данных, есть витрины, есть BI, отчёты работают, пользователи что-то смотрят. Кажется, что смысл уже присутствует — он же где-то «зашит» в SQL, моделях и формулах.
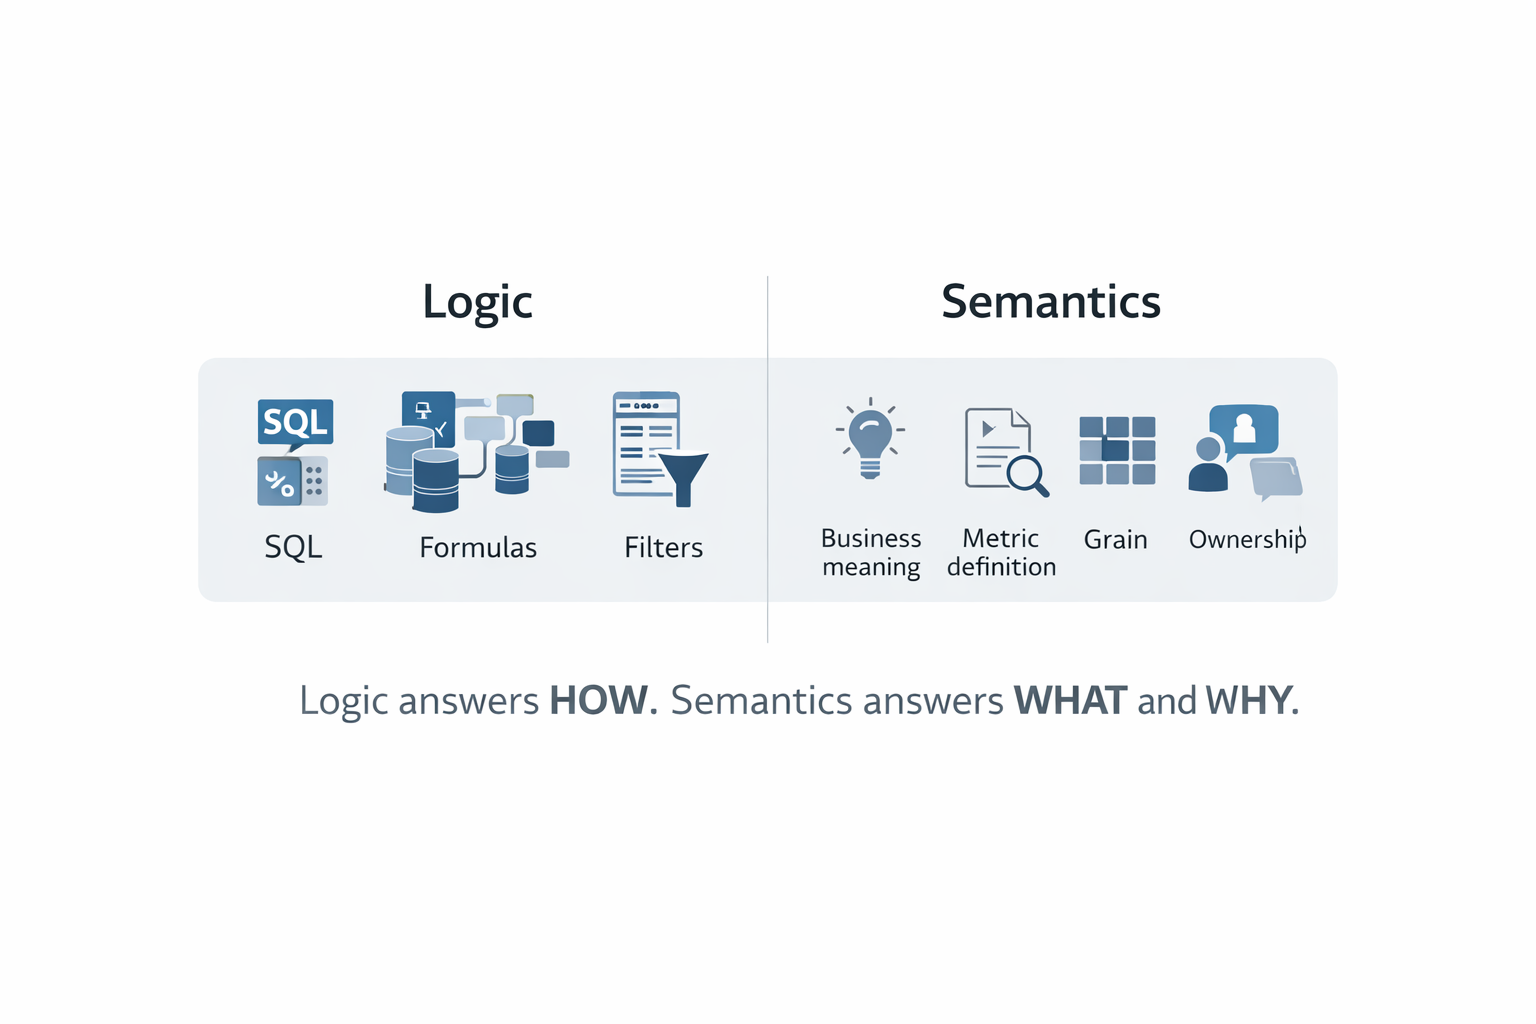
Проблема в том, что наличие логики не означает наличие семантики.
Логика отвечает на вопрос «как посчитать». Семантика отвечает на вопрос «что именно мы считаем, зачем и в каких границах это имеет смысл». Эти вопросы часто смешивают, но именно из-за этого и возникают конфликты.
· Логика — это формулы, join’ы, фильтры, CASE WHEN, условия агрегации
· Семантика — это:
Если сказать грубо и честно:
Типичный пример выглядит так. В одном отчёте выручка считается как сумма оплаченных заказов. В другом — как сумма отгруженных. В третьем — с учётом возвратов. Формулы могут быть технически корректными, но бизнес-смысл у них разный. Когда все они называются одинаково, система перестаёт быть источником истины и превращается в поле интерпретаций.
Очень часто пытаются решить эту проблему организационно: договориться, написать методологию, зафиксировать определения в документах. Но семантика, вынесенная за пределы системы, неизбежно устаревает. Рано или поздно формулы меняются, а описание — нет. Или наоборот.
Семантический слой возникает не тогда, когда смысл описан, а тогда, когда он исполняется.
Представим простую метрику — Выручка.
SUM(amount)SUM(amount) - discountsВсе отчёты формально правильные.
Но:
И в этот момент BI перестаёт быть системой поддержки решений и становится системой конфликтов.
Очень часто пытаются лечить это так:
Это не работает по одной простой причине:
Семантика, которая живёт вне системы, — не живёт.
Если метрика описана в Confluence, а считается в BI — рано или поздно они разъедутся.
Одна из самых распространённых ошибок — рисовать семантический слой как отдельный прямоугольник между витринами и BI. Такая схема создаёт ощущение, что семантику можно «положить» в одно место и считать задачу решённой.
На практике семантический слой физически распределён, но логически централизован. Часть семантики неизбежно живёт в модели данных, часть — в трансформациях, часть — в описаниях метрик, часть — в правилах доступа и контекста. Попытка собрать всё в одном компоненте либо приведёт к монстру, либо закончится тем, что этот компонент начнут обходить.
Гораздо продуктивнее думать о семантическом слое как о наборе ролей, которые должна закрывать архитектура:
Если эти роли закрыты — семантический слой есть, даже если он реализован несколькими инструментами. Если нет — его нет, даже если куплен «semantic module».
Семантический слой — это слой, в котором:
Важно:
Семантический слой — это не интерфейс. Это контракт.
Это тоже принципиально важно проговорить, чтобы сразу убрать путаницу.
Семантический слой — это не:
Все эти вещи могут быть частью реализации, но не являются семантическим слоем сами по себе.
Почему DWH и витрины не решают проблему семантики
DWH и витрины отлично решают другие задачи:
Но у них есть ограничения:
В результате:
Что происходит, когда появляется семантический слой
Когда семантический слой сделан правильно, происходят очень конкретные изменения:
И главное:
BI, API и AI перестают спорить между собой.
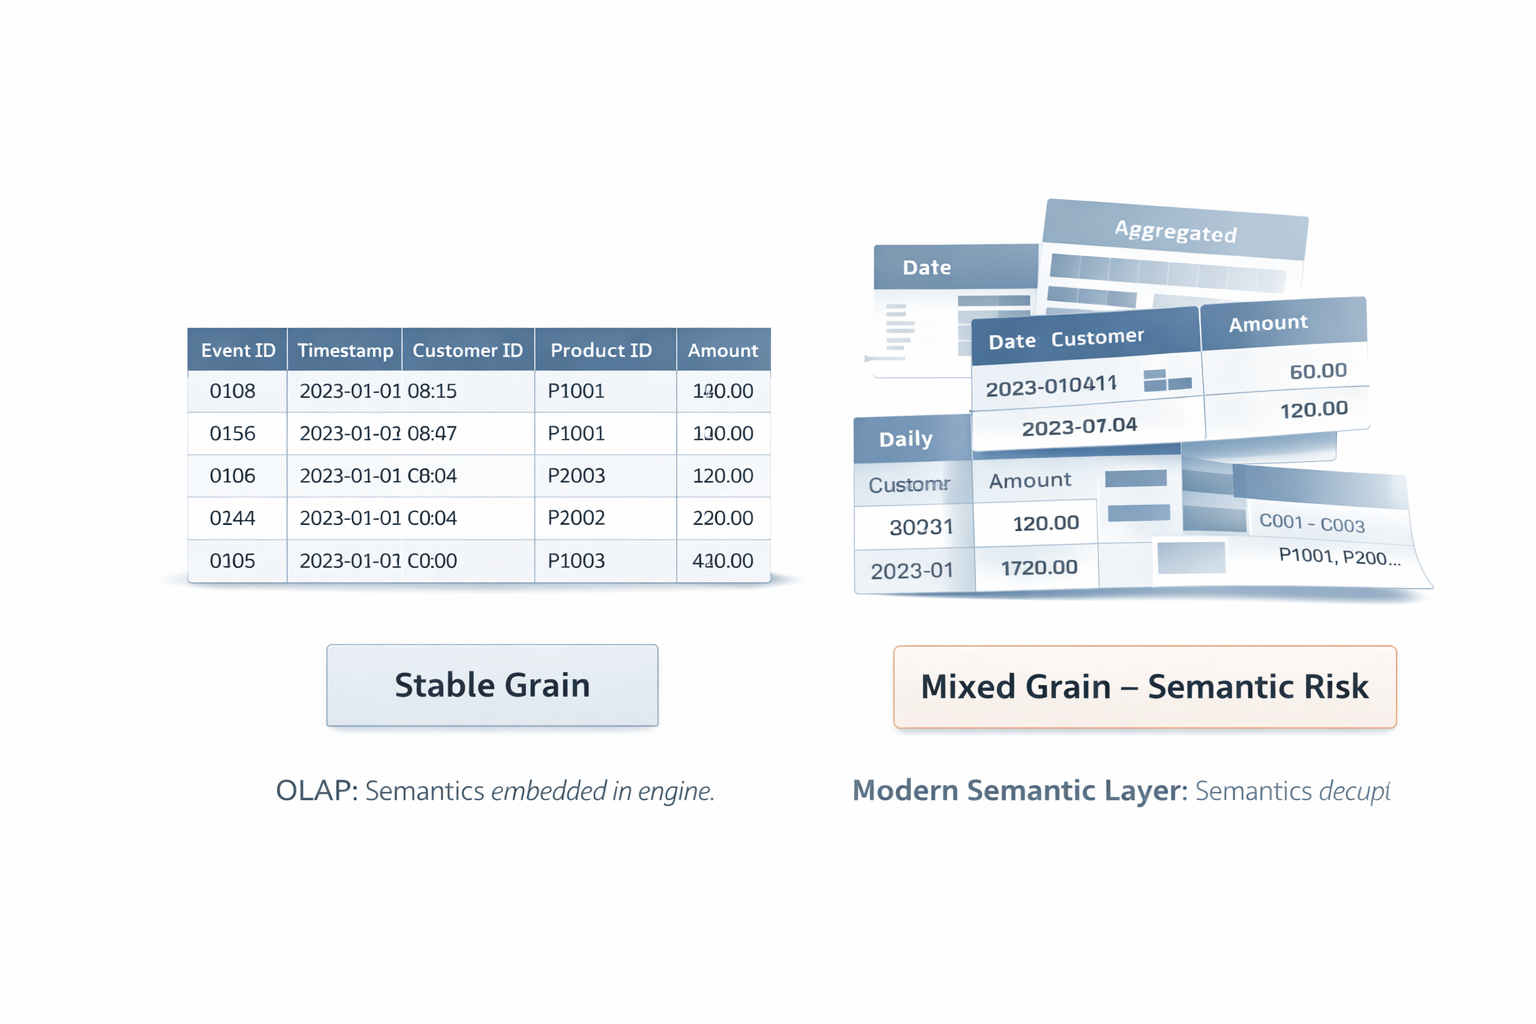
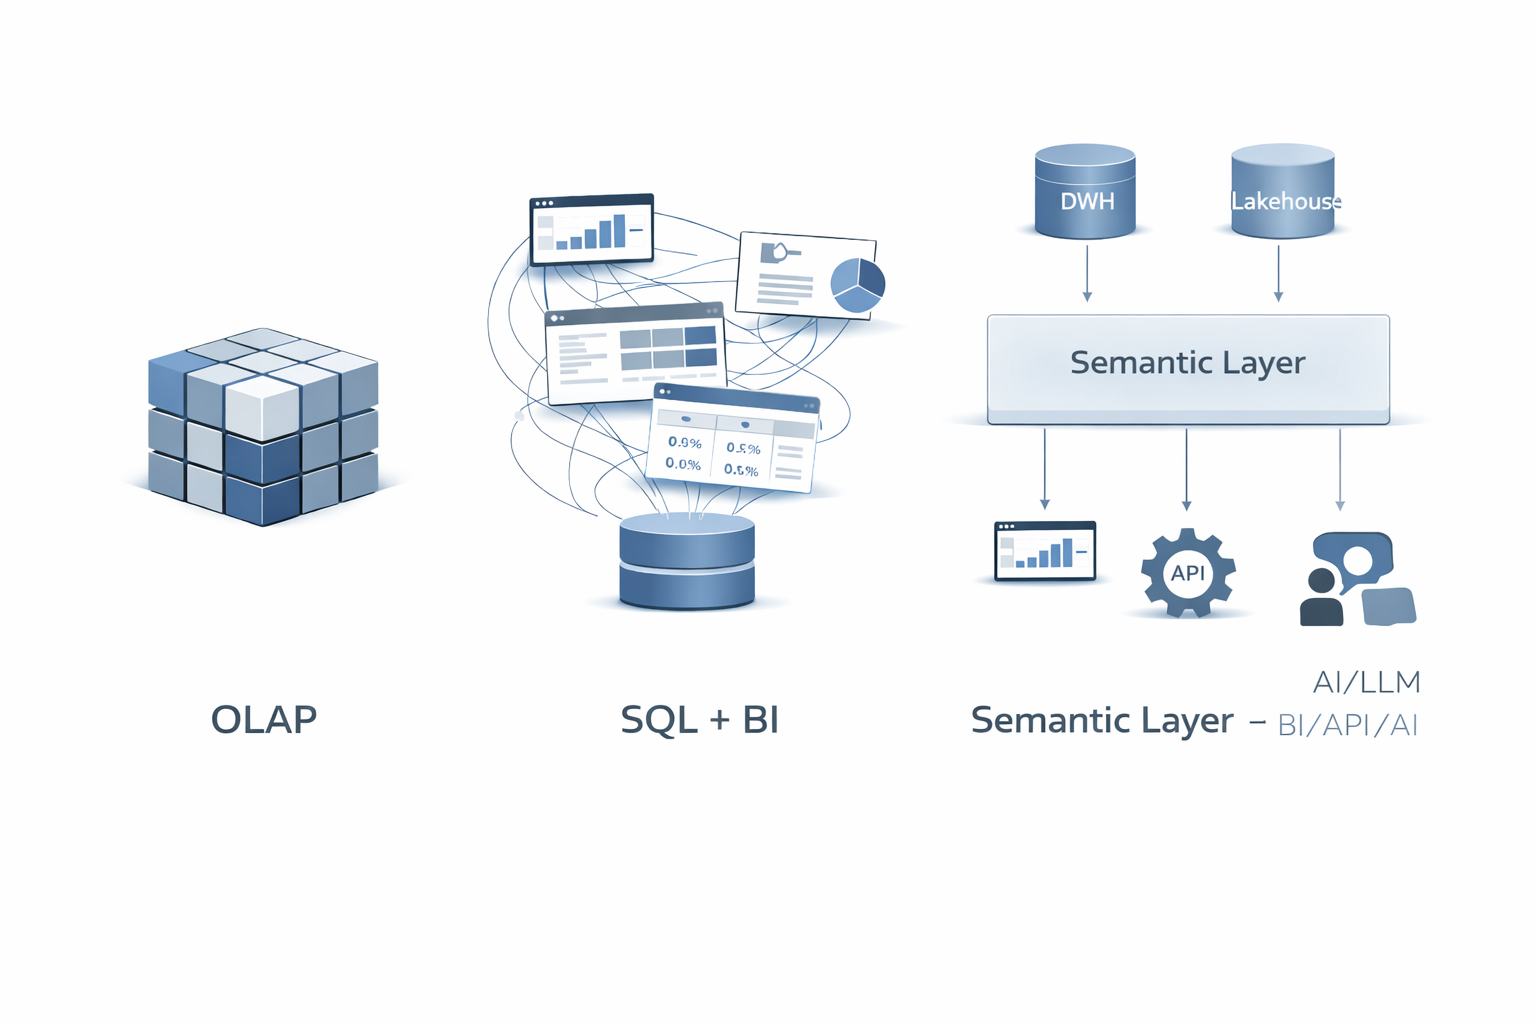
Разговор о семантическом слое невозможно вести, не упомянув OLAP. Не потому что OLAP — это «правильный путь», а потому что именно там индустрия впервые столкнулась с тем, что смысл нужно защищать архитектурно.
OLAP-куб заставлял сначала определить измерения, иерархии, меры, допустимые агрегации, а уже потом задавать вопросы. Пользователь не мог произвольно соединять поля или менять логику расчёта. Это ограничивало гибкость, но обеспечивало удивительную для своего времени консистентность.
Именно поэтому многие до сих пор интуитивно ищут семантический слой в OLAP-подходах. Там он был, но в форме жёсткой, монолитной и плохо адаптирующейся к изменениям.
Почему вообще возникает ощущение, что семантика уже есть в OLAP
Если вы когда-то работали с классическими OLAP-кубами, вы помните, что там уже было почти всё, что мы сегодня приписываем semantic layer:
И в этом смысле интуиция абсолютно верная:
OLAP — это первая массовая реализация семантического слоя в индустрии.
Причём реализация очень строгая и дисциплинирующая.
Как OLAP на самом деле решал задачу семантики
Важно понять, что именно делал OLAP, и почему он так долго доминировал.
OLAP не просто хранил агрегаты.
Он навязывал модель мышления:
То есть OLAP был не просто технологией, а контрактом между бизнесом и данными.
В этом смысле OLAP — это семантический слой жёсткого типа.
Почему OLAP был одновременно силой и ограничением
И вот здесь начинается самое важное.
OLAP решал проблему семантики ценой гибкости.
Что это значит на практике:
OLAP отлично работал, когда:
OLAP начинал ломаться, когда:
Современный semantic layer пытается решить ту же задачу — сохранить смысл — но в мире, где:
По сути, мы пытаемся вернуть дисциплину OLAP, не возвращаясь к его ограничениям. И это намного сложнее, чем просто построить куб.
Ключевая разница между OLAP и современным semantic layer
Очень важно не путать наличие семантики и архитектурную роль.
OLAP:
Современный semantic layer:
Если сказать совсем честно:
OLAP — это семантический слой, встроенный в вычислительный движок.
Современный semantic layer — это семантический слой, отделённый от движка.
Почему многие до сих пор “ищут” семантический слой в OLAP
Потому что там он ощущается.
В OLAP:
И это то, чего часто не хватает в современных SQL+BI архитектурах.
Поэтому люди интуитивно думают:
«Может, мы зря отказались от OLAP? Может, там и был настоящий semantic layer?»
Ответ:
он там был — но в форме, которая плохо живёт в современной экосистеме.
Почему OLAP плохо сочетается с современным self-service
Self-service сегодня — это не “дай пользователю доступ”.
Это:
OLAP плохо переносит неопределённость.
Он любит, когда мир заранее описан.
Современный бизнес — нет.
Где OLAP до сих пор оправдан
И это тоже важно сказать вслух, без фанатизма.
OLAP по-прежнему отлично работает, если:
В таких сценариях OLAP действительно является семантическим слоем, и зачастую очень хорошим.
Почему современные semantic layer не повторяют OLAP один в один
Потому что они решают другую задачу.
Современный semantic layer:
Он слабее в дисциплине,
но сильнее в адаптивности.
Главный вывод, который важно зафиксировать
Если сформулировать аккуратно, но предельно ясно:
OLAP — это жёсткая реализация семантического слоя старой эпохи.
Современный semantic layer — это гибкая реализация той же идеи,
но в мире SQL, API, ML и self-service.
И самое важное:
Когда мы сегодня говорим «нам нужен semantic layer»,
мы почти всегда имеем в виду не возврат к OLAP,
а попытку вернуть дисциплину смысла без жёсткости OLAP.
Когда разговор переходит от архитектурных идей к реализации, почти всегда возникает соблазн упростить задачу. Хочется найти «тот самый инструмент», который «даёт семантический слой», установить его и считать проблему решённой. Это понятно: так нас приучили многие годы вендорских решений. Но в open-source мире эта логика не работает.
Причина проста: open-source экосистема развивалась не как единый продукт, а как набор специализированных инструментов, каждый из которых решал свою задачу. В результате семантический слой в open-source — это результат согласованной архитектуры, а не наличие одного компонента.
Чтобы это понять, важно честно посмотреть на роли, которые вендорские OLAP-платформы закрывали внутри себя, и на то, как эти роли сегодня распределены между разными слоями стека.
Когда разговор доходит до инструментов, почти всегда происходит подмена смысла.
Вопрос звучит так:
«Какой open-source инструмент даёт семантический слой?»
А правильный вопрос должен звучать иначе:
«Какие роли семантического слоя закрываются какими инструментами — и где проходят границы их ответственности?»
Потому что в open-source мире нет одного “semantic layer продукта”, как это было в эпоху классического OLAP.
Есть экосистема, где каждый инструмент решает свою часть задачи, и семантический слой возникает на стыке.
Хранилище данных: почему семантика начинается раньше, чем кажется
Начнём с самого низа, с того места, которое многие вообще не связывают с семантикой.
Возьмём классический open-source стек:
PostgreSQL, ClickHouse, иногда связку с Trino и Iceberg.
Формально это просто хранилище и вычисления.
Но на практике именно здесь закладывается возможность или невозможность семантики.
Если в хранилище:
то дальше вы будете не строить семантический слой, а латать противоречия.
Очень важный момент, который часто недооценивают:
Семантический слой не может быть строже, чем модель данных под ним.
OLAP это решал жёсткой схемой.
SQL-мир требует дисциплины от архитектора.
На первый взгляд кажется странным говорить о семантическом слое, начиная с хранилища данных. Ведь хранилище — это «просто данные». Но именно здесь закладываются ограничения, которые потом невозможно компенсировать никаким semantic engine.
Если в хранилище не зафиксированы бизнес-события, если факты смешивают разные уровни детализации, если одни и те же сущности представлены несколькими несовместимыми способами, семантический слой будет постоянно бороться не за смысл, а за выживание.
В хорошо спроектированном хранилище каждое событие отвечает на простой и конкретный вопрос: «что произошло и когда». Продажа, отгрузка, платёж, визит, начисление — это не строки таблицы, это бизнес-факты. И у каждого факта есть минимальный уровень детализации, который нельзя нарушать без потери смысла.
Очень часто в реальных проектах этот принцип нарушается из лучших побуждений. В таблицу фактов добавляют агрегаты «для удобства», присоединяют справочники «чтобы не делать join», добавляют вычисляемые поля «чтобы BI быстрее работал». В моменте это кажется оптимизацией, но стратегически это уничтожает возможность построить устойчивую семантику.
Семантический слой не может быть строже, чем модель данных под ним. Если модель допускает неоднозначность, semantic layer будет вынужден либо повторять эту неоднозначность, либо скрывать её за сложными правилами, которые никто не понимает.
Хранилище данных не является семантическим слоем, но без него нормального semantic layer не бывает.
Роль DWH здесь простая и очень конкретная:
Если на уровне хранилища:
— никакой семантический слой сверху это не спасёт.
Очень распространённая ошибка — пытаться компенсировать плохую модель семантикой.
Это не работает.
Семантика появляется в момент, когда вы перестаёте думать таблицами и начинаете думать понятиями бизнеса.
Например:
sales_fact.amount , а «Выручка»customer_id , а «Клиент»created_at , а «Дата заказа»И вот здесь принципиальный момент:
Семантика — это не переименование колонок.
Это фиксация смысла, контекста и ограничений.
Если вы просто сделали alias — вы ещё ничего не сделали.
Следующий уровень, на котором часто возникает путаница, — это трансформации. В современных open-source архитектурах именно здесь чаще всего появляется dbt или аналогичные инструменты. И именно здесь многие команды ошибочно считают, что уже строят семантический слой.
dbt действительно делает с данными нечто важное. Он заставляет команду мыслить не отдельными SQL-запросами, а моделями. Он поощряет явные имена, описания, тесты, зависимости. Он вводит понятие контракта между слоями. Всё это критически важно для семантики.
Но есть принципиальное различие между подготовкой данных к семантике и реализацией семантики.
Трансформационный слой отвечает на вопрос: «какие у нас есть устойчивые, корректные и согласованные данные». Он не должен отвечать на вопрос: «как бизнес интерпретирует эти данные в разных контекстах».
Как только в трансформациях начинают появляться KPI, управленческие показатели, сложные бизнес-правила «для отчёта», слой начинает выполнять не свою роль. Он становится жёстким, плохо адаптируемым и начинает конкурировать с BI и semantic engines.
Правильная роль трансформаций — создать semantic-ready данные. То есть такие данные, которые:
Это фундамент, но не сам семантический слой.
Практически во всех современных архитектурах трансформационный слой становится первым уровнем семантической стабилизации.
Именно здесь:
Очень важно понимать:
трансформационный слой — это не место для аналитики,
а место для подготовки семантически корректных объектов.
Если здесь начинается логика уровня:
И здесь почти всегда появляется dbt или его аналоги.
И вот здесь происходит критическая развилка.
Очень многие думают, что dbt — это и есть семантический слой.
Это не так, но dbt — это его фундамент.
Почему.
dbt заставляет вас:
Это первый момент в архитектуре, где данные начинают приобретать форму бизнес-объектов, а не просто таблиц.
Но есть принципиальное ограничение:
dbt описывает что за данные у нас есть,
но не как бизнес должен их интерпретировать в разных контекстах.
Как только вы начинаете:
вы ломаете разделение слоёв.
Правильное использование dbt — это подготовка semantic-ready объектов, а не реализация семантики целиком.
Семантический слой начинается не в момент, когда вы написали SQL, и не в момент, когда построили витрину. Он начинается тогда, когда вы впервые делаете следующий шаг: отделяете смысл метрики от способа её визуализации и запроса.
Это очень тонкий, но принципиальный момент. До него вы всё ещё работаете в парадигме «отчёт → данные». После него вы переходите в парадигму «смысл → потребление».
В open-source экосистеме этот шаг чаще всего реализуется через semantic engines или через декларативные описания метрик, которые живут отдельно от BI. Важно не то, каким инструментом вы это делаете, а то, что происходит архитектурно.
Метрика перестаёт быть формулой внутри отчёта. Она становится объектом с именем, смыслом, контекстом и ограничениями. BI, API и другие потребители начинают запрашивать не таблицы и поля, а бизнес-понятия.
Именно здесь появляется настоящий семантический слой, даже если он пока минимален и обслуживает один-два сценария.
Настоящий семантический слой начинается там, где:
В open-source экосистеме эту роль чаще всего берут на себя semantic engines.
Один из самых ярких примеров — Cube.
Важно понимать, что такие инструменты:
Их задача — интерпретировать данные, а не готовить их.
Почему semantic engine — это не “ещё один BI”
Это очень частое заблуждение.
Cube, и похожие инструменты, не пытаются быть BI.
Они пытаются быть программируемым смыслом.
Что это означает на практике.
Вместо того чтобы:
вы описываете:
И дальше эта логика используется:
Это ключевой архитектурный сдвиг.
Еще раз, семантический слой начинается в тот момент, когда:
Это может быть:
Ключевое — семантика становится независимой от визуализации.
На этом этапе почти всегда возникает сопротивление со стороны BI-команд. Это понятно: исторически именно BI был местом, где «всё сходится». Там писались формулы, там проверялись цифры, там принимались финальные решения о том, что показывать бизнесу.
Проблема в том, что BI по своей природе ориентирован на потребление, а не на владение смыслом. Он отлично справляется с визуализацией, фильтрацией, интерактивным анализом. Но как только в BI начинают жить бизнес-метрики, система теряет переносимость и устойчивость.
Каждый новый дашборд становится ещё одной интерпретацией. Каждое calculated field — ещё одной версией правды. Перенос в другой BI-инструмент превращается в переписывание всей логики. Self-service начинает разрушать консистентность, а не усиливать её.
Семантический слой нужен ровно для того, чтобы BI перестал быть местом, где определяется смысл. BI должен стать клиентом семантики, а не её владельцем.
BI — отличное место для:
BI — плохое место для:
Когда семантика живёт в BI:
Это не вина BI.
Это просто не его архитектурная роль.
А что тогда делают BI-системы
BI-системы в open-source мире — Apache Superset, Metabase — часто создают иллюзию, что семантический слой можно сделать прямо в них.
И действительно:
Но здесь есть принципиальное ограничение:
Семантика в BI почти всегда локальна.
Она:
BI может потреблять семантику,
но плохо справляется с ролью центра смысла.
Правильное разделение ответственности
Если говорить очень упрощённо, но честно:
Как только эти роли начинают смешиваться — система деградирует.
Как понять, что у вас уже есть зачатки семантического слоя
Хороший диагностический вопрос, который я часто задаю командам:
Если завтра вы смените BI,
сколько бизнес-логики вам придётся переписать?
Если BI ещё можно «поддерживать вручную», то API сразу вскрывает архитектурные проблемы. Как только вы пытаетесь отдать метрику через API, становятся очевидны все недосказанности.
Что означает эта метрика?
Какие параметры допустимы?
В каком временном контексте она считается?
Как она ведёт себя при фильтрации?
Если на эти вопросы нет чётких ответов, API либо не получится, либо станет источником ошибок.
Именно поэтому API — лучший индикатор того, что семантический слой действительно существует. Метрика, которую нельзя безопасно отдать по API, скорее всего, не является устойчивой семантической метрикой. Она слишком завязана на конкретный отчёт или конкретный сценарий.
Одно из самых распространённых опасений звучит так: «Если мы зафиксируем семантику, мы убьём self-service». На практике происходит ровно обратное.
Self-service ломается не от ограничений, а от неопределённости. Пользователь боится использовать данные, когда не понимает, что именно он считает. Он начинает сомневаться в цифрах и возвращается к Excel.
Хорошо спроектированный семантический слой делает self-service возможным именно потому, что снимает необходимость каждый раз интерпретировать данные заново. Пользователь работает с понятиями, которым можно доверять, и тратит время не на проверку формул, а на анализ и принятие решений.
Современный контекст делает разговор о семантике ещё более актуальным. LLM и AI-ассистенты не понимают таблицы и поля так, как их понимают люди. Они оперируют словами, контекстами и вероятностями.
Если вы даёте AI доступ напрямую к данным без семантического слоя, он начинает угадывать смысл. Иногда удачно, иногда нет. Проблема в том, что ошибки AI звучат уверенно и убедительно, и это делает их особенно опасными.
Семантический слой в этом контексте становится контекстом доверия. Он ограничивает пространство интерпретаций, с которым работает AI, и снижает вероятность того, что модель будет «галлюцинировать» управленческие выводы.
Почти любой разговор о семантическом слое рано или поздно упирается в странное ощущение. Формально всё сделано правильно: данные есть, трансформации есть, метрики описаны, BI подключён. Но цифры всё равно «плавают». Стоит добавить измерение — и значение меняется. Стоит посмотреть тот же показатель в другом отчёте — и он уже другой.
В девяти случаях из десяти причина не в формуле и не в инструменте. Причина в grain.
Grain — это не технический термин и не атрибут таблицы. Это ответ на вопрос: какое минимальное бизнес-событие зафиксировано в данных. Пока на этот вопрос нет однозначного ответа, семантический слой невозможен в принципе.
Проблема в том, что многие команды считают grain чем-то само собой разумеющимся. Кажется, что он «очевиден», «понятен», «и так видно из таблицы». Но как только данные начинают использоваться в разных контекстах, эта неявность превращается в источник системных ошибок.
Если в предыдущих блоках мы говорили «зачем» и «где», то здесь начинается честный разговор «как именно это делать руками».
И начинать нужно не с метрик.
Не с KPI.
Не с дашбордов.
Начинать нужно с grain.
Почему grain — это фундамент всего семантического слоя
Grain — это уровень детализации факта.
Звучит просто, но на практике это самая частая причина поломки семантики.
Когда я прихожу в проекты и вижу проблемы с метриками, почти всегда выясняется, что:
И тогда начинается магия:
Это не баг BI и не проблема SQL.
Это отсутствие семантической дисциплины.
Как правильно думать о grain (человеческим языком)
Самый простой способ объяснить grain не технической аудитории — задать вопрос:
«Какое минимальное бизнес-событие мы фиксируем?»
Например:
Если вы не можете ответить на этот вопрос одной фразой, у вас нет grain — у вас есть таблица.
И здесь важный момент:
Grain — это не про SQL.
Это про бизнес-смысл события.
Типовая ошибка: «универсальная» таблица фактов
Очень распространённая ситуация в DWH без семантического мышления:
Делают таблицу, в которую:
В итоге получается не факт, а мешок данных.
На этом мешке:
Semantic layer поверх такого фундамента превращается в компенсационный механизм, а не в источник истины.
Как делать правильно: один факт — один grain
Правильный подход скучный, но надёжный.
Для каждого факта вы:
Да, это требует больше таблиц.
Да, это требует дисциплины.
Но это единственный способ, при котором семантический слой потом будет работать.
Почему grain нельзя «починить потом»
Очень распространённый путь выглядит так. Сначала строят хранилище «побыстрее». Затем поверх него делают отчёты. Потом, когда появляются расхождения, начинают говорить о семантическом слое как о способе «навести порядок».
Здесь возникает иллюзия, что семантический слой может компенсировать плохой grain. На практике это невозможно.
Если одна таблица одновременно содержит данные:
то никакой semantic engine не сможет однозначно определить, как агрегировать метрику при добавлении измерения. Он может лишь выбрать один из вариантов или скрыть проблему, но смысл уже утрачен.
Grain — это не настройка. Это фундаментальное решение, которое нельзя отложить.
Grain как бизнес-утверждение, а не как технический параметр
Очень важно перестать воспринимать grain как «уровень детализации таблицы». Это техническое описание, но оно вторично.
Правильный вопрос звучит так:
что в нашей системе считается элементарным фактом реальности.
Продажа — это заказ или строка заказа?
Платёж — это транзакция или факт закрытия обязательства?
Клиент — это физическое лицо, аккаунт или договор?
На эти вопросы нельзя ответить универсально. Они зависят от бизнеса. Но на них обязательно нужно ответить явно.
Семантический слой начинается не с SQL, а с формулировки таких утврждений.
Следующий шаг после фиксации grain — определение бизнес-сущностей. И здесь снова возникает типичная ловушка: команды думают, что сущности — это просто таблицы справочников.
На практике бизнес-сущность — это не таблица и даже не объект данных. Это устойчивое понятие в управленческой модели бизнеса.
Клиент, продукт, заказ, контракт, кампания, склад — все эти слова кажутся очевидными, пока не начинаешь задавать уточняющие вопросы. Когда клиент становится клиентом? Может ли он перестать им быть? Может ли один клиент иметь несколько идентификаторов? Что считается продуктом — SKU, бренд, категория? Эти вопросы кажутся «бизнесовыми», но именно они определяют, будет ли семантический слой работать.
Если сущность не определена, метрики, которые на неё опираются, становятся хрупкими. Любое изменение в данных начинает менять смысл показателей, даже если формула остаётся прежней.
Перестеньте мыслить таблицами и начните мыслить бизнес-сущностями.
Очень часто я слышу фразы:
Это технический язык.
Семантический слой требует другого.
Правильные вопросы звучат так:
Пока на эти вопросы нет ответов, никакая метрика не будет устойчивой.
Почему семантический слой — это всегда про ограничения
На этом этапе часто возникает сопротивление. Хочется оставить всё гибким, не фиксировать определения, «чтобы не мешать аналитике». Но именно здесь скрывается ключевой парадокс.
Семантический слой не ограничивает аналитику. Он ограничивает некорректные интерпретации.
Если метрика может быть посчитана в любом разрезе, это не означает, что все эти разрезы имеют бизнес-смысл. И если система позволяет пользователю делать семантически бессмысленные запросы, она подрывает доверие к результатам.
Хорошо спроектированный семантический слой говорит не только «что можно», но и «что нельзя». И это не недостаток, а его главная ценность.
Семантический слой — это не про «дать пользователям всё».
Это про ограничение допустимых интерпретаций.
Если у метрики:
— это не метрика, а формула.
OLAP это решал жёстко.
Современный semantic layer решает это декларативно.
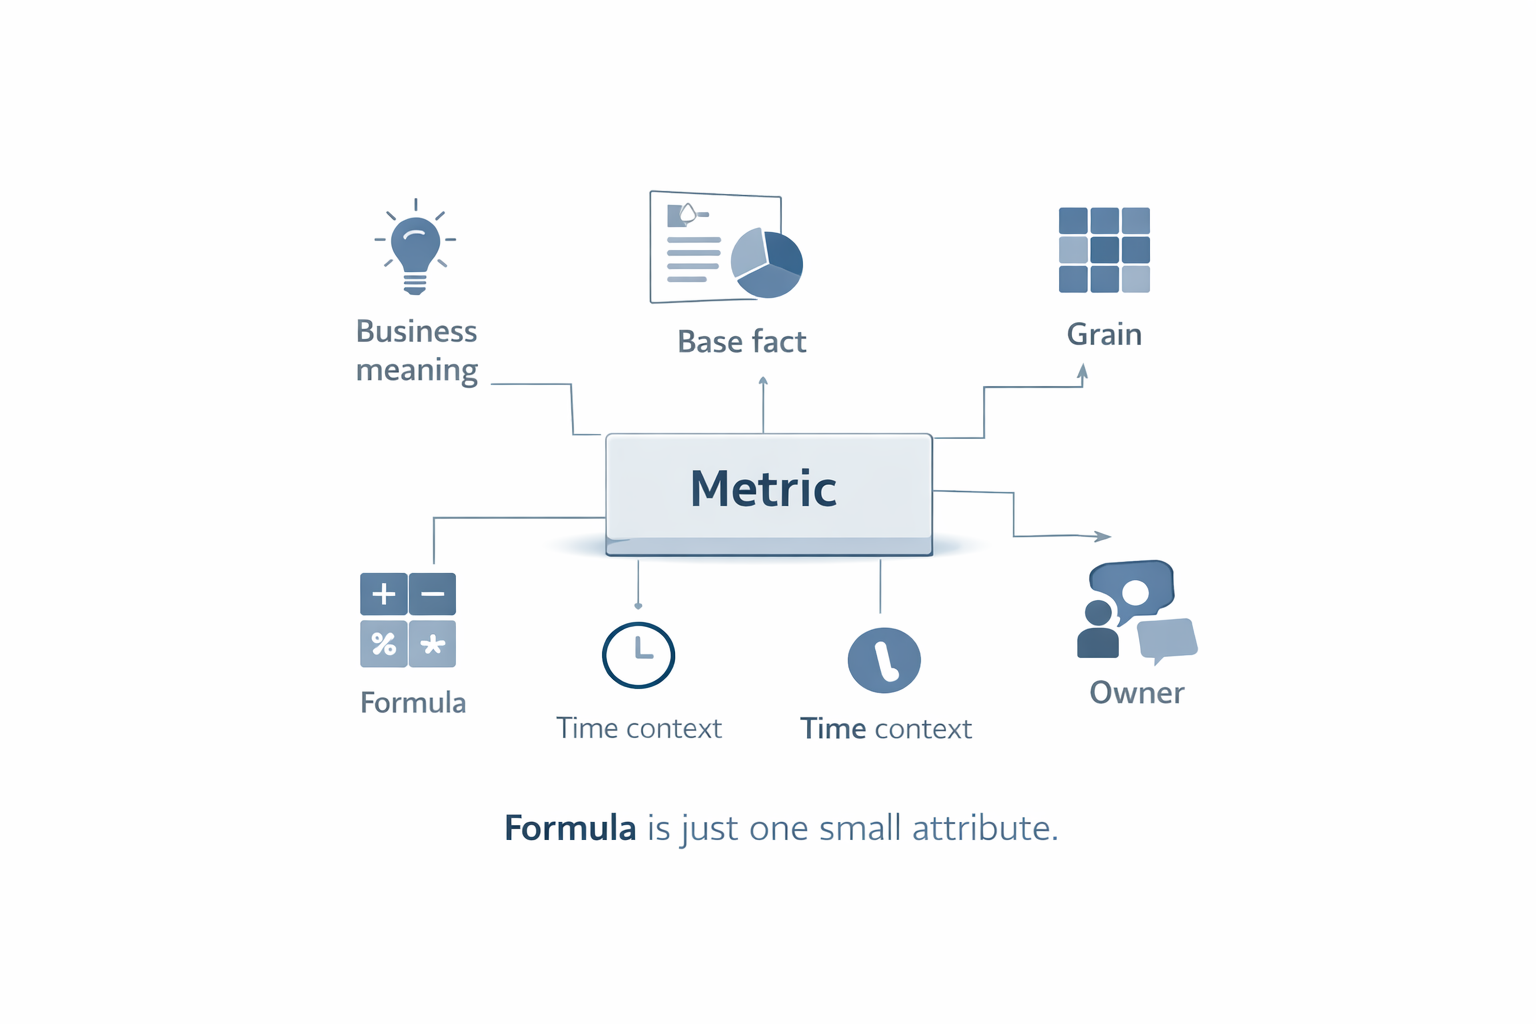
Когда разговор доходит до метрик, многие команды возвращаются к привычному мышлению. Формула кажется чем-то конкретным и проверяемым, в отличие от абстрактных разговоров о смысле.
Но формула — это всего лишь один из аспектов метрики. Если вы воспринимаете метрику как формулу, вы неизбежно сталкиваетесь с дублированием, расхождениями и конфликтами.
Метрика в семантическом слое — это объект, у которого есть:
Формула здесь вторична. Она может измениться, не меняя смысл метрики, или наоборот — остаться прежней, но изменить смысл из-за изменения контекста.
Почему одинаковая формула не означает одинаковую метрику
Одна из самых частых ловушек — считать, что если формула совпадает, значит метрика та же самая. В реальности контекст решает всё.
Количество заказов, посчитанное по строкам заказов, и количество заказов, посчитанное по заголовкам заказов, могут технически выглядеть одинаково, но семантически это разные показатели. То же самое касается выручки, маржи, среднего чека.
Если такие различия не зафиксированы в семантическом слое, они неизбежно начинают проявляться хаотично, в зависимости от того, кто и где считает показатель.
На этом этапе полезно перестать думать о метрике как о выражении SUM(x).
Метрика — это:
Если при добавлении измерения пользователь спрашивает:
«А почему цифра изменилась?»
— значит, семантика метрики не зафиксирована.
Это тонкий момент, но он критичен для self-service.
Ошибочный подход:
Правильный подход:
Именно здесь semantic layer становится ускорителем, а не тормозом.
Компания делает self-service BI.
Пользователи довольны.
Через полгода:
После внедрения semantic layer:
Это не магия.
Это просто явно зафиксированный смысл.
Отдельного разговора заслуживает тема KPI. Почти всегда бизнес приходит с запросом «сделать KPI», и кажется логичным начинать именно с них.
Проблема в том, что KPI — это агрегаты над агрегатами, зависящие от управленческой модели, которая сама по себе может меняться. Если вы строите семантический слой вокруг KPI, вы привязываете его к текущему состоянию бизнеса и лишаете гибкости.
Гораздо устойчивее начинать с атомарных метрик, которые отражают базовые факты, и уже из них собирать KPI. Такой подход позволяет менять управленческую модель, не разрушая фундамент семантики.
И здесь я сделаю, возможно, непопулярное заявление.
Если вы начинаете проект semantic layer с:
— вы почти гарантированно:
Семантический слой всегда строится снизу вверх, даже если бизнес думает, что наоборот.
Очень распространённый анти-паттерн — «универсальные» метрики.
Например:
С точки зрения семантики это разные метрики, даже если формула одна.
Когда вы пытаетесь уместить всё в одну — вы:
Очень часто в попытке упростить систему создают универсальные метрики, которые «умеют всё». Например, одна метрика выручки с флагами «с возвратами или без», «по оплате или по отгрузке».
С точки зрения семантики это почти всегда ошибка. Такие метрики теряют прозрачность, становятся трудными для объяснения и опасными для self-service. Пользователь может получить разные значения одного и того же показателя, даже не осознавая, что изменил контекст.
Семантический слой ценен именно тем, что делает различия явными. Если показатели различаются по смыслу, они должны различаться и по имени, и по объекту.
До этого момента мы говорили про фундамент: grain, факты, сущности.
Теперь мы подходим к тому, ради чего всё это обычно и затевается — к метрикам.
И здесь почти все делают одну и ту же ошибку:
они думают, что метрика — это формула.
Формула — это способ вычисления.
Метрика — это бизнес-понятие.
Если вы воспринимаете метрику как SUM(amount) или COUNT(DISTINCT order_id), вы неизбежно:
Правильный вопрос звучит не так:
«Как посчитать метрику?»
А так:
«Что это за метрика, где и в каком контексте она имеет смысл?»
В хорошем semantic layer метрика — это объект со свойствами.
Даже если физически она описана в YAML или коде, мысленно вы должны воспринимать её как сущность со следующими характеристиками:
Обрати внимание:
формула здесь — не первое и не главное.
Возьмём простой пример — количество заказов.
Технически:
COUNT(order_id)Но семантически это могут быть разные метрики:
Если вы называете всё это «Orders» и различаете только фильтрами — вы уже разрушили семантику.
Правильный подход — это разные метрики с разными именами и явным смыслом.
На этом этапе важно зафиксировать ещё одну мысль. Семантический слой часто воспринимают как способ сделать аналитику удобнее. Это верно лишь отчасти.
Его главная функция — сделать аналитику безопаснее.
Он защищает бизнес от:
Это особенно важно в крупных организациях, где одни и те же данные используются сотнями людей с разным уровнем подготовки.
Одна из самых недооценённых функций semantic layer — защита.
Хорошо спроектированная метрика:
Это звучит как ограничение, но на практике:
именно это делает self-service возможным.
Пользователь не должен быть экспертом в модели данных.
Он должен работать с понятиями, которым можно доверять.
Многие недооценивают роль названий и описаний.
На практике:
Если у вас есть метрика с названием вроде:
Total SalesRevenueAmountи при этом нет:
— это не семантический слой, а просто удобный ярлык.
Я обычно предлагаю командам такой порядок мышления.
Сначала вы задаёте вопрос:
«Какое управленческое решение опирается на эту метрику?»
Если решения нет — метрика, скорее всего, не нужна.
Затем:
«На каком бизнес-событии она основана?»
Это возвращает вас к grain.
Затем:
«В каких разрезах её имеет смысл анализировать, а в каких — нет?»
И только потом:
«Как именно она считается технически?»
Если вы делаете наоборот — сначала формула, потом всё остальное — семантика будет хрупкой.
Очень частый вопрос:
«А где хранить формулу метрики — в dbt или в semantic engine?»
Правильный ответ зависит от типа логики.
Есть логика:
Её место — в трансформациях.
Есть логика:
Её место — в семантическом слое.
Если вы всё тащите в трансформации, вы получаете жёсткость.
Если всё тащите в BI — хаос.
Semantic layer существует ровно для того, чтобы разделить эти типы логики.
До этого момента семантический слой существует в относительно «стерильной» среде. Есть данные, есть модели, есть описанные метрики. Всё это выглядит логично и аккуратно, пока не появляется главный вопрос: как этим пользуются.
И вот здесь происходит ключевой переход. Семантический слой перестаёт быть архитектурным артефактом и становится инфраструктурой смысла. Он начинает обслуживать разные типы потребителей, каждый из которых по-своему интерпретирует данные, задаёт вопросы и принимает решения.
Если этот поток смысла не продуман, семантика распадается. Если продуман — она начинает масштабироваться.
Почему семантический слой не может быть «про один интерфейс»
Исторически аналитические системы проектировались вокруг одного основного потребителя — отчётности. Даже когда появлялся self-service, он всё равно оставался внутри BI. Это создавало иллюзию, что семантика — это просто удобный слой между данными и визуализацией.
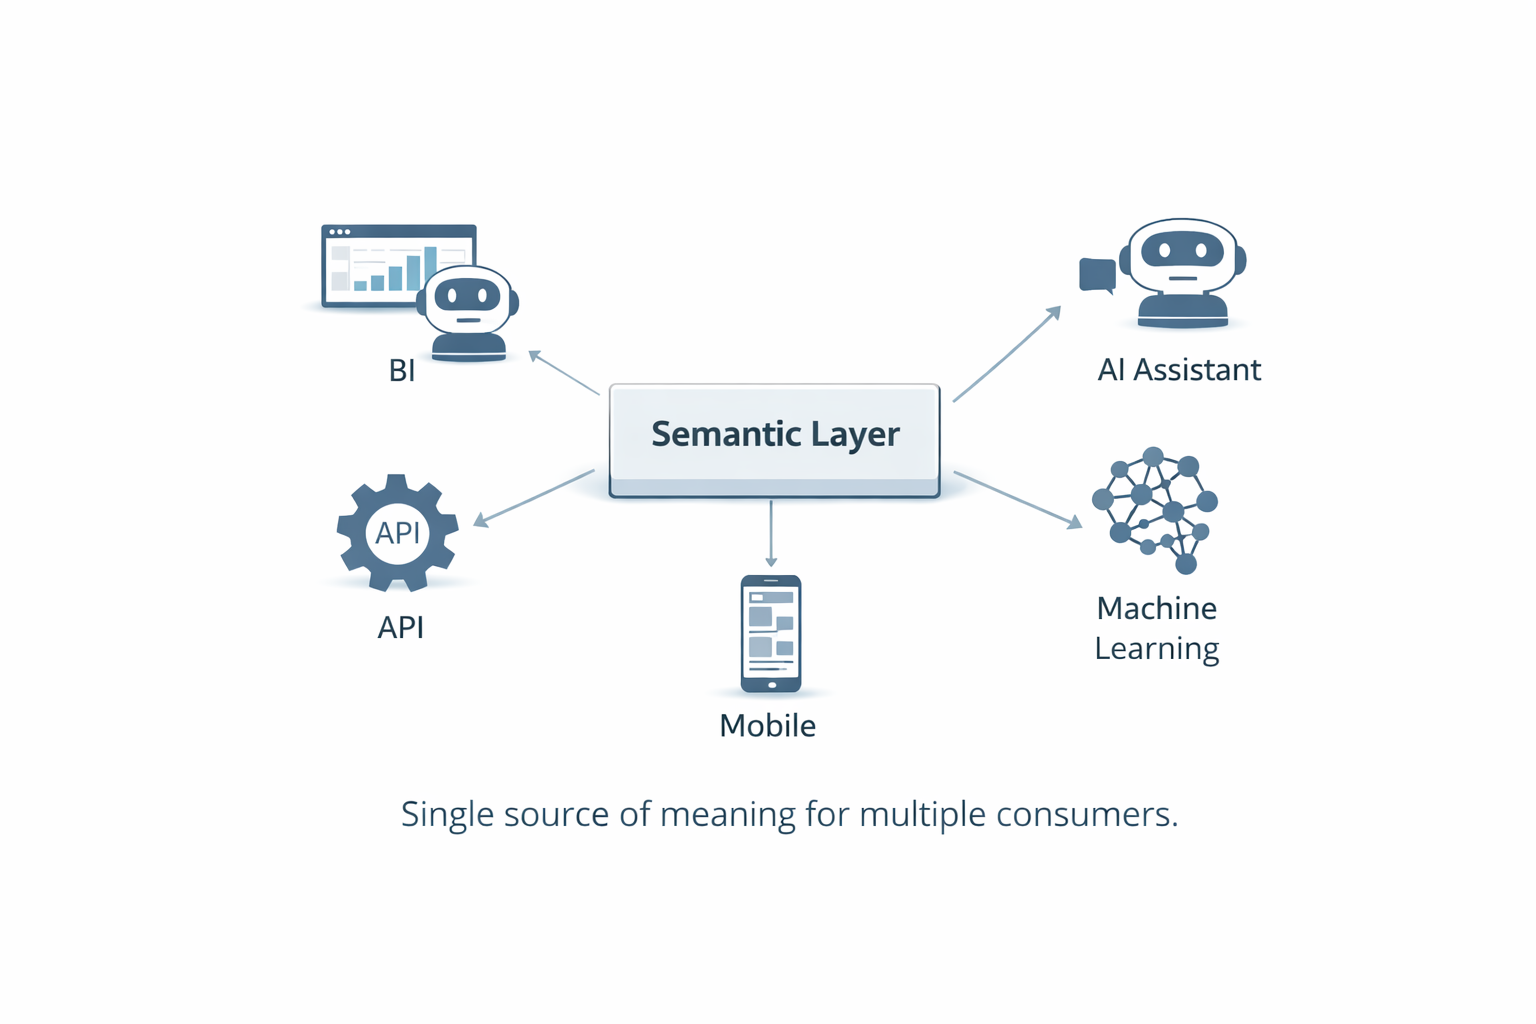
Современная реальность разрушает эту модель. Сегодня данные потребляют:
Если семантический слой ориентирован только на BI, он неизбежно начинает «течь» в остальных сценариях. Каждому новому потребителю приходится заново интерпретировать данные, и смысл снова расползается.
Настоящий semantic layer должен быть интерфейсно-независимым. Он не знает, кто именно его использует. Он просто предоставляет интерпретированные бизнес-понятия по единым правилам.
До этого момента мы говорили о фундаменте: данные, grain, сущности, метрики.
И вот здесь возникает очень опасная иллюзия:
«Ну всё, семантика описана. Теперь BI просто подключим — и поедем».
На практике именно на этом шаге многие проекты semantic layer деградируют.
Не потому что семантика плохая, а потому что непонятно, как её правильно потреблять.
Самый болезненный момент внедрения семантического слоя почти всегда связан с BI. Причина проста: BI исторически был местом, где «всё сходится». Там принимались финальные решения о формулах, фильтрах, агрегатах. Там аналитики чувствовали контроль.
Когда появляется semantic layer, эта роль меняется. BI больше не определяет смысл. Он потребляет его.
Это не просто технический сдвиг. Это сдвиг в ответственности и в культуре работы с данными. BI-разработчики перестают быть архитекторами смысла и становятся архитекторами представления.
Если этот переход не принят, семантический слой обречён. BI начнёт жить своей жизнью: появятся calculated fields, локальные фильтры, «временные» формулы. Через некоторое время окажется, что BI снова стал источником истины — но уже в обход семантики.
Исторически BI-системы привыкли быть центром логики.
Там:
Когда появляется semantic layer, роль BI должна измениться, и это часто вызывает сопротивление — как техническое, так и организационное.
BI должен:
Семантический слой — это не библиотека и не справочник.
Он начинает иметь смысл только в момент потребления.
И здесь ключевая мысль, которую важно проговорить вслух:
Если разные потребители получают разную интерпретацию одной и той же метрики —
у вас нет семантического слоя, даже если он формально существует.
Почему «оставить calculated fields на всякий случай» — плохая идея
Почти в каждом проекте звучит аргумент: «Давайте оставим calculated fields, вдруг понадобится». На первый взгляд это выглядит разумно. На практике это почти всегда подрывает семантический слой.
Как только BI позволяет переопределять метрики, пользователи начинают это делать. Не из злого умысла, а из желания быстро решить задачу. Через несколько месяцев оказывается, что в системе снова несколько версий одной и той же метрики, и никто уже не помнит, какая из них «правильная».
Семантический слой требует жёсткого принципа: бизнес-метрики не определяются в BI. BI может агрегировать, фильтровать, визуализировать, но не интерпретировать.
Если BI ещё можно «обмануть» интерфейсом, то API обмануть нельзя. Именно поэтому API — лучший индикатор зрелости семантического слоя.
Когда вы пытаетесь отдать метрику по API, сразу становятся очевидны все слабые места:
API заставляет формализовать семантику. Он превращает её в контракт. Метрика либо имеет чёткое определение, либо не может быть безопасно использована вне конкретного отчёта.
В этом смысле API — не дополнительная нагрузка, а архитектурный инструмент, который помогает выявить и устранить семантические пробелы.
API сразу вскрывает:
Именно поэтому я всегда говорю:
Если ваша метрика не может быть отдана по API —
она, скорее всего, не является полноценной семантической метрикой.
API заставляет:
По сути, API превращает семантику в программный контракт.
Сегодня данные потребляют не только аналитики.
Это:
Если каждый из этих потребителей:
— вы возвращаетесь в мир Excel, только распределённый.
Semantic layer нужен ровно для того, чтобы этого не происходило.
Одно из самых устойчивых заблуждений заключается в том, что семантический слой якобы противоречит self-service аналитике. Кажется, что фиксация смысла ограничивает свободу пользователей.
На практике происходит обратное. Self-service ломается не из-за ограничений, а из-за неопределённости. Пользователь, который не уверен в цифрах, либо перестаёт использовать систему, либо начинает проверять всё вручную.
Хороший семантический слой снимает эту неопределённость. Он даёт пользователю набор понятий, которым можно доверять. Внутри этих понятий пользователь может свободно исследовать данные, не опасаясь, что он «посчитает что-то не так».
Таким образом, семантический слой не убивает self-service, а делает его масштабируемым.
Когда пользователь:
— он либо перестаёт использовать BI, либо начинает считать в Excel.
Семантический слой снимает эту неопределённость:
Конфликт почти всегда возникает в одном месте:
Semantic layer — это компромисс:
Если попытаться:
Поэтому семантический слой — это не только техника, но и договор между ролями.
Появление LLM-ассистентов и AI-агентов резко усилило значение семантического слоя. Машины не обладают интуицией и контекстом, которыми пользуются люди. Они оперируют тем, что им предоставлено.
Если AI получает доступ напрямую к таблицам и полям, он вынужден угадывать смысл. Иногда удачно, иногда нет. Проблема в том, что его ошибки звучат уверенно и убедительно.
Семантический слой в этом контексте становится контекстом доверия. Он ограничивает пространство интерпретаций, с которым работает модель, и снижает риск того, что AI будет делать логически неверные выводы из формально корректных данных.
Без семантического слоя AI превращается в генератор правдоподобной ерунды. С семантическим слоем он начинает работать с управленческими понятиями.
AI и LLM не понимают ваши таблицы.
Они не знают, что такое amount, status_id или flag = 1.
Без semantic layer AI:
С семантическим слоем:
По сути, semantic layer становится контекстом доверия для AI.
Если сформулировать предельно прямо:
Семантический слой существует не ради BI.
Он существует ради множественных потребителей смысла.
BI — лишь один из них.
И если вы проектируете семантику только под BI, вы:
Даже хорошо спроектированный семантический слой может начать разрушаться, если поток смысла не контролируется. Чаще всего это происходит в трёх случаях.
Первый — когда появляются новые потребители, для которых семантика не была предусмотрена. Например, мобильное приложение или ML-модель начинает использовать данные напрямую, минуя semantic layer.
Второй — когда бизнес требует срочных изменений, и команда делает временные исключения «на пару недель». Эти исключения почти никогда не исчезают.
Третий — когда отсутствует явное владение семантикой, и каждый потребитель начинает интерпретировать её по-своему.
Во всех этих случаях смысл начинает утекать, и семантический слой постепенно превращается в декоративный элемент.
Когда семантический слой только появляется, он почти всегда выглядит аккуратно. Метрик немного, все они свежие, команда помнит, зачем и как они сделаны. В этот момент возникает ложное чувство, что дальше система будет жить «сама».
Это опасная иллюзия.
Семантический слой — это слой про смысл, а смысл — самая нестабильная часть любой системы. Он меняется вместе с бизнесом, стратегией, рынком, продуктами и даже с тем, как компания сама себя понимает. Если управление семантикой не встроено в архитектуру, она начинает разрушаться быстрее, чем логика в BI или SQL.
Причина проста: ошибки в семантике не всегда заметны сразу. Отчёт может выглядеть корректным, цифры — правдоподобными, решения — логичными. Но через несколько месяцев выясняется, что разные команды вкладывали в одни и те же показатели разный смысл.
На этом этапе у многих команд появляется ложное ощущение завершённости:
«Мы описали метрики, подключили BI, всё работает — значит, semantic layer готов».
На самом деле это только середина пути.
Потому что настоящая сложность semantic layer — не в создании, а в изменениях.
И если вы не продумали управление заранее, семантика начинает расползаться ровно так же, как когда-то расползлась логика в BI.
Метрики — это не просто расчёты.
Метрики — это обещания бизнесу.
Когда вы меняете:
вы фактически меняете интерпретацию прошлого.
И здесь возникает фундаментальный конфликт:
Если этот конфликт не разрешён архитектурно, он решается хаосом.
Один из самых частых сценариев деградации семантики выглядит так. Команда обнаруживает, что метрика считалась «не совсем правильно». Иногда это действительно ошибка, иногда — изменение бизнес-правил. Самый простой путь — поправить формулу и задеплоить изменения.
Технически всё работает. Но семантически происходит катастрофа.
Смысл метрики меняется задним числом. Исторические данные начинают означать что-то другое, чем раньше. Старые отчёты перестают сходиться с сохранёнными презентациями, цифры в памяти пользователей конфликтуют с новыми значениями, доверие к системе падает.
Здесь важно зафиксировать ключевой принцип:
Семантический слой не имеет права незаметно менять смысл.
Если смысл меняется — это должно быть явным событием, а не техническим refactor’ом.
Очень типичная ситуация.
Обнаружили, что метрика считалась «не совсем правильно».
Самый простой путь — поменять формулу.
Через неделю:
И вот здесь важно проговорить ключевой принцип:
Семантический слой не имеет права тихо менять смысл.
Если смысл меняется — это событие, а не refactor.
Очень часто команды пытаются применить к семантике привычные подходы из разработки: git, теги, версии. Это полезно, но недостаточно.
Метрики — это не функции. Это бизнес-артефакты. Их версии должны быть понятны не только инженерам, но и бизнесу.
Когда появляется новая версия метрики, важно, чтобы было ясно:
В зрелом семантическом слое новая версия метрики — это новая сущность, а не замена старой. Старая может продолжать существовать, пока есть потребители, которые на неё опираются. Это кажется избыточным, но именно так сохраняется доверие.
Одна из самых частых ошибок — пытаться версионировать метрики как функции.
Но метрики — это не функции.
Это бизнес-артефакты.
Поэтому версионирование должно отвечать не на вопрос:
«Что изменилось в коде?»
А на вопрос:
«Как изменилось управленческое понимание показателя?»
На практике это означает:
И очень важно:
старая версия не обязана исчезать сразу.
Зрелый подход выглядит примерно так.
Вы:
Это кажется «избыточным», но именно так:
OLAP решал это жёстко — пересборкой кубов.
Современный semantic layer должен решать это декларативно и прозрачно.
Если задать в компании вопрос «кто владеет этой метрикой», очень часто в ответ можно услышать тишину или размытые формулировки. «Аналитики», «финансы», «data team» — всё это признаки отсутствия реального владения.
Семантический слой требует двойного ownership.
С одной стороны, должен быть бизнес-владелец — человек или роль, которая отвечает за смысл метрики, за то, какие управленческие решения на неё опираются и как она должна интерпретироваться.
С другой стороны, должен быть технический владелец, который отвечает за корректную реализацию, соответствие модели данных, тесты и стабильность.
Если хотя бы одной из этих ролей нет, метрика становится ничейной. А ничейные метрики всегда деградируют.
Очень часто data governance воспринимается как набор документов, регламентов и презентаций. Они могут быть полезны, но сами по себе они не меняют поведение системы.
Семантический слой — это способ сделать governance исполняемым.
Все ключевые вопросы governance — что такое показатель, кто за него отвечает, где он используется, какие ограничения применяются — должны находить отражение в семантическом слое. Не в виде текста на wiki, а в виде работающих правил.
Если governance существует только «на бумаге», а семантика живёт своей жизнью, конфликт неизбежен. Если же семантический слой становится техническим воплощением governance, система начинает работать согласованно.
Data governance говорит:
Semantic layer делает это исполняемым.
Если governance живёт только в документах — он не работает.
Если семантика живёт только в коде — она не управляется.
Именно здесь они должны встретиться.
В контексте семантического слоя документация — это не вторичный артефакт. Это часть архитектуры.
Хорошая документация метрики не объясняет SQL. Она объясняет:
Если метрику невозможно понять без устного объяснения, семантический слой не завершён. Это особенно критично в больших организациях, где команды и люди постоянно меняются.
Один из самых недооценённых эффектов семантического слоя проявляется не сразу. Он проявляется тогда, когда в компании что-то меняется: BI-инструмент, ключевые аналитики, структура команд, бизнес-модель.
Если семантика зашита в BI или в голове нескольких людей, система теряет устойчивость. Знания уходят вместе с людьми, отчёты приходится пересобирать, старые решения теряют контекст.
Если же семантический слой отделён от визуализации и зафиксирован архитектурно, изменения становятся управляемыми. BI можно заменить, команды могут обновляться, а смысл остаётся.
Финальный и очень практический вопрос: с чего начинать, чтобы семантический слой вообще появился.
Самая частая ошибка — пытаться сделать всё сразу. Описать все метрики, все сущности, все сценарии. Это почти гарантированно приводит к перегрузке и остановке проекта.
Гораздо эффективнее начать с одного бизнес-контекста и ограниченного набора метрик. Не с KPI всей компании, а с конкретного сценария, где боль от отсутствия семантики ощущается сильнее всего.
Семантический слой должен начать приносить пользу рано. Иначе он останется архитектурным упражнением.
Самый частый сценарий провала выглядит так:
Команда:
Через пару месяцев:
Вывод простой, но болезненный:
Семантический слой ценен не полнотой, а использованием.
Правильный старт — это один бизнес-контекст.
Не вся компания.
Не все KPI.
Не вся модель данных.
Один понятный сценарий:
И внутри него:
Если semantic layer не начинает приносить пользу на малом масштабе, он не взлетит и на большом.
Если отбросить всё лишнее, минимально жизнеспособная конструкция выглядит так:
Всё остальное — API, AI, каталог, версии — может добавляться позже, когда появляется реальный спрос.
Это важный психологический момент для команды:
semantic layer — не монолит, а наращиваемая система.
Он звучит знакомо:
«Давайте сначала наведём порядок в данных,
а потом сделаем semantic layer».
Проблема в том, что «потом» не наступает.
Semantic layer как раз и является механизмом наведения порядка, но на уровне смысла, а не таблиц.
Лучше:
Есть несколько очень надёжных признаков зрелости, даже на раннем этапе.
Вы видите, что:
Если этого нет — семантический слой существует только формально.
В какой-то момент руководство почти всегда спрашивает:
«А в чём экономический эффект?»
И здесь важно отвечать честно.
Semantic layer:
Он:
Это эффект масштаба, а не one-off результат.
Если собрать всё, о чём мы говорили, в одну мысль:
Semantic layer — это попытка:
сохранить дисциплину OLAP
без жёсткости OLAP
в мире SQL, self-service и AI
И это не инструмент.
Это способ мышления о данных.
Если попытаться свести всё сказанное к одной мысли, она будет такой.
Семантический слой — это не продукт, не инструмент и не модуль. Это момент, когда компания перестаёт спорить о цифрах и начинает спорить о решениях.
Он требует дисциплины, архитектурного мышления и готовности ограничивать интерпретации. Но взамен он даёт то, чего не дают ни DWH, ни BI по отдельности — устойчивый, масштабируемый смысл.
В мире open-source, self-service и AI семантический слой становится не роскошью, а необходимым условием зрелой работы с данными. И чем раньше это осознаётся, тем меньше усилий потребуется, чтобы его построить.
Практический вопрос, который почти всегда возникает после прочтения подобного материала: как управлять семантикой не в презентации, а в реальной системе? Как хранить определения метрик, версионировать смысл, фиксировать grain и ownership так, чтобы это не превратилось в набор разрозненных документов? Именно для решения этой задачи создавался DataForge — как инструмент визуального моделирования и управления семантическим слоем поверх хранилища данных. Он позволяет описывать сущности, метрики и их взаимосвязи декларативно, сохраняя контроль над смыслом независимо от BI-инструментов. Если вам близка идея исполняемой семантики, имеет смысл посмотреть, как это реализовано на практике.
DataForge - это система для визуального моделирования и проектирования структуры хранилищ данных (DWH). Он позволяет пользователям визуально проектировать таблицы фактов методом drag-and-drop, автоматически генерировать физическую и логическую модели данных, документировать бизнес-логику и определения атрибутов, а также генерировать DDL-скрипты для создания физической модели в реляционной СУБД.
DataForge © 2025-2026 Все права защищены.